

SALMONN-2官网
SALMONN-2 是由清华大学、上海人工智能实验室与剑桥大合开源的通用音频大语言模型(Audio LLM)。该项目以字节跳动自研的 SPEAR 统一自监督音频编码器为前端,搭配多层特征融合适配器,并以 Qwen3 作为文本基座,用约 1.8 万小时监督数据,在 MMAU-Pro、MMAR、MMSU 三大综合音频基准上取得了同规模开源模型中的最佳表现。SALMONN-2 的价值在于把语音识别、环境声理解、音乐理解以及声音检测、音频深度伪造检测、语音质量评估等进阶能力统一到一个生成式框架内,为开发者提供了一套可直接部署、可二次训练的音频理解基础模型。项目以 GitHub 仓库作为官方主页,同时公开了 HuggingFace 权重与 arXiv 技术论文。
SALMONN-2的主要功能
- 通用音频理解:覆盖语音识别、音频描述生成、音乐理解、情绪识别与说话人验证等跨域任务,单一模型即可应对多种音频输入。
- 声音检测(SED):能够定位并输出环境声(如狗叫、脚步声、警报)的起止时间段,以时间戳形式返回具体区间。
- 音频深度伪造检测:判断语音是否为合成或篡改,并进一步定位疑似伪造的局部时间片段,可用于诈骗与虚假内容识别。
- 语音质量评估(SQA):感知噪声、失真、清晰度等低层声学特征,给出可解释的质量评分,定位存在缺陷的音频片段。
- 多模态上下文语音识别(MICL):结合文本拼写与参考发音音频,显著提升生僻词、罕见人名与专业术语的识别准确率。
SALMONN-2的技术原理
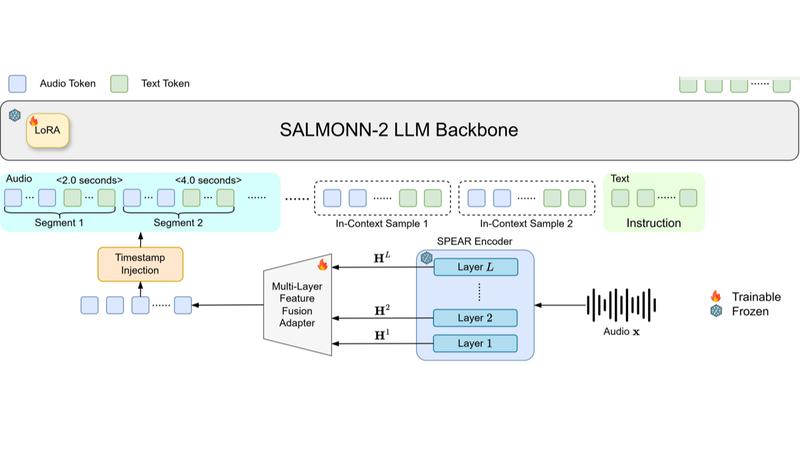
- 统一自监督音频编码器:SPEAR 在大规模无标注音频上通过自监督学习训练,能够同时捕捉语义、发音、音色、说话人与声学环境信息,以单一前端替代传统的 Whisper 加 BEATs 双编码器方案。
- 多层特征融合适配器:MLF 适配器对各层隐状态做归一化与拼接,再经下投影与帧分组压缩,把层次化表征映射到语言模型嵌入空间,使模型能按需调用不同层级的声学线索。
- 时间戳注入机制:模型将时间戳以自然语言文本(如 <2.0 seconds>)直接插入音频序列,与音频嵌入交错输入语言模型,无需额外的专用时间戳嵌入层即可完成时间定位。
- 多模态上下文学习训练:在上下文语音识别中同步引入参考发音音频,并采用干扰词与目标词随机丢弃策略,防止模型过度依赖文本偏置。
如何使用SALMONN-2
使用流程如下:
- 访问 GitHub 仓库 https://github.com/bytedance/SALMONN/tree/salmonn2,使用 git clone 将项目代码下载到本地;
- 执行 conda create -n salmonn2 python=3.10 创建并激活虚拟环境,升级 pip、setuptools 与 wheel;
- 在仓库根目录运行 pip install -r requirements.txt 与 pip install -e . –no-deps,完成运行依赖安装;
- 通过 HuggingFace CLI 下载模型检查点:hf download marcoyang/SALMONN-2-8B –repo-type model –local-dir /path/to/salmonn-2-hf;
- 用 AutoProcessor 与 AutoModelForCausalLM 加载本地权重,传入音频文件与指令文本,调用 model.generate() 即可获得音频理解结果。
SALMONN-2的使用场景
- 智能会议助手:实时转录会议内容,并结合参会人的发音示例准确识别外籍人名与专业术语;
- 音频内容审核:自动检测直播或播客中的异常声音,并识别深度伪造语音以防范诈骗内容;
- 语音质量监控:对客服通话、录音棚素材做自动化质量评分,快速定位噪声与失真片段;
- 多媒体档案检索:为历史音频、广播节目生成带时间戳的描述,实现基于内容的精准检索;
- 辅助听障设备:将门铃、警报等环境声以文字加时间戳的形式实时提示听障用户。
SALMONN-2的常见问题解答
- SALMONN-2 是开源模型吗,商用是否需要授权?
- SALMONN-2 已在 GitHub 公开代码与 HuggingFace 权重,属于开源项目。具体商用授权需以仓库内 LICENSE 文件与官方说明为准,商业部署前建议先确认许可证条款。
- 运行 SALMONN-2 需要怎样的硬件?
- 公开的 SALMONN-2-8B 检查点基于 8B 文本基座,本地推理通常需要具备足够显存的英伟达 GPU;更大规模的 30B-A3B 版本对算力要求更高,实际部署应结合自身硬件条件选择权重。
- SALMONN-2 相比传统双编码器方案好在哪里?
- 传统方案常采用 Whisper 加 BEATs 两个编码器分别处理语音与音频,能力不均衡且架构复杂。SALMONN-2 用单一 SPEAR 编码器配合多层特征融合适配器,在语音、环境声、音乐与副语言任务间取得更均衡的表现,同时简化了整体结构。
SALMONN-2官网网址
SALMONN-2官网入口网址:https://github.com/bytedance/SALMONN/tree/salmonn2
SALMONN-2模型权重托管在 HuggingFace:https://huggingface.co/marcoyang/SALMONN-2-8B
SALMONN-2技术论文见 arXiv:https://arxiv.org/pdf/2607.17079
OpenI AI时代点评
SALMONN-2 代表了通用音频大语言模型在「小而精」方向上的一个重要进展:它用远低于同行的监督数据量,在多个综合基准上追平甚至超越规模相近的开源方案,并首次把声音检测、音频伪造检测、语音质量评估等长期被忽视的声音分析能力系统纳入统一框架。对开发者而言,其开源属性与清晰的本地部署流程降低了音频智能应用的落地门槛。如果你也在关注 AI 工具的实际落地,OpenI 导航站内收录的 WorkBuddy 与 OpenClaw 同样值得了解,前者聚焦智能体式办公协作,后者面向自动化任务编排,都可作为构建多模态工作流的参考。
数据评估
本站OpenI提供的SALMONN-2都来源于网络,不保证外部链接的准确性和完整性,同时,对于该外部链接的指向,不由OpenI实际控制,在2026年 8月 10日 下午4:45收录时,该网页上的内容,都属于合规合法,后期网页的内容如出现违规,可以直接联系网站管理员进行删除,OpenI不承担任何责任。
相关导航


全面、高效的AI工具产品情报,发现和使用最酷的AI工具!
Ctrl + D 或 ⌘ + D 收藏本站到浏览器书签栏。