

OpenI.One官网
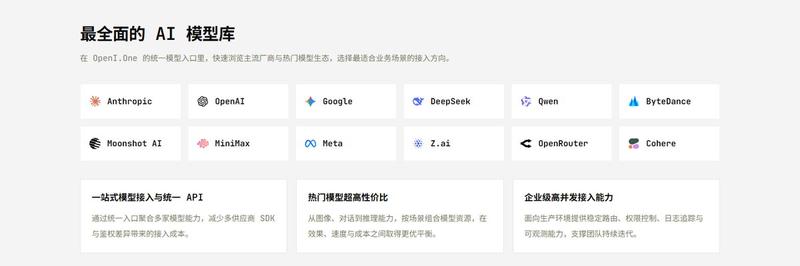
OpenI.One(主站域名 openi.one)是一个企业级 AI ,官方给自己的定位是「全球主流 AI 大模型 MaaS 智能路由平台」。它要解决的问题很具体:当一个团队同时要用 OpenAI、Google、Anthropic、DeepSeek 等多家的模型时,每家的密钥、SDK、限流规则、错误码和计费口径都不一样,业务代被上游的每一次变更牵着走。OpenI.One 在中间加了一层标准化接入层,把多家的模型收敛到统一的地址和统一的密钥体系下调用,路由、故障切换与调用记录都交给处理。
从接入形态上看,它同时提供两类接口:面向图像的 OpenAI Image API 兼容路径(/v1/images/generations 与 /v1/images/edits),以及 Google Gemini 原生的 generateContent 路径,另有一条统一的异步任务查询接口。控制台侧提供令牌管理、分组与模型维度的权限控制、请求日志与余额明细,支持把令牌一键导入 Cherry Studio、AI as Workspace 等第三方客户端。官网页脚标注的运营主体为 ModelWay(中国香港)。
接入方式上,注册后在控制台创建令牌即可开始调用,统一调用地址为 https://openi.one,模型广场、控制台与接口文档都挂在同一个域名下。
OpenI.One的主要功能:
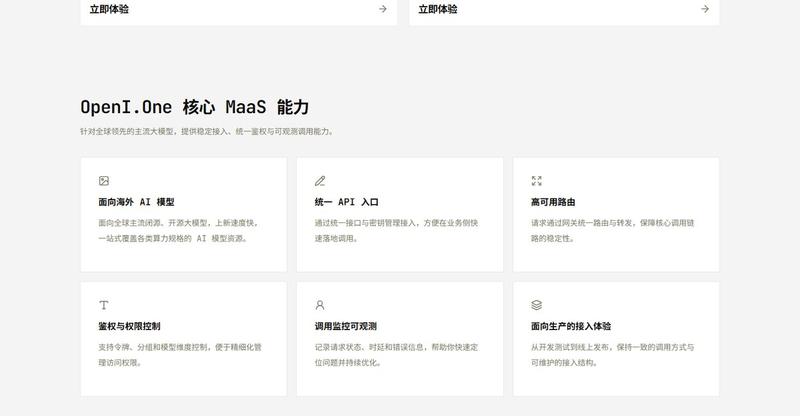
- 统一 API 入口:两套主流协议并存。图像生成走 OpenAI 风格的 /v1/images/*,尺寸用 宽x高 像素或 auto;Gemini 系列走原生 /v1beta/models/{model}:generateContent,模型名写在路径里,尺寸用宽高比与 1K/2K/4K 分辨率桶。同一个令牌可以跨两套协议调用;
- 高可用路由与流量调度:内置智能路由引擎,负责突破 RPM 上限、故障自动切换与流量精细化调度,由统一转发请求,业务侧不必针对单一上游写降级逻辑;
- 鉴权与权限控制:请求统一用 Authorization: Bearer 令牌鉴权,控制台支持按令牌、分组、模型三个维度控制访问范围,便于按环境拆分令牌;
- 调用监控与可观测:记录请求状态、时延与错误信息,请求日志与余额明细可按模型、状态和时间维度追踪,支持数据导出,便于对账与持续优化;
- 同步/异步双调用模式:在任意同步路径后追加 ?async=true 即可转为异步任务,提交后立即返回 task_id,再通过统一的 GET /v1/tasks/{task_id} 轮询结果,支持幂等键与完成回调地址;
- 安全与合规能力:内置内容审核机制过滤违规与敏感内容、请求加密传输、企业数据不参与训练;对外链参考图做 SSRF 防护,私有 IP 与保留地址会被拒绝,同时对图片大小、下载超时与并发数设了上限;
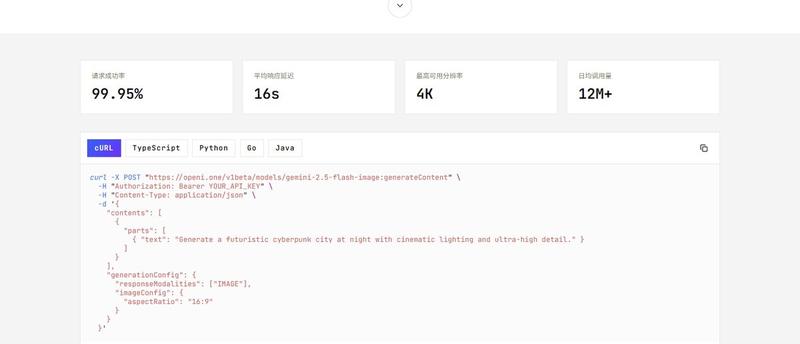
- 接入体验与示例:站内提供模型体验页与 cURL、TypeScript、Python、Go、Java 五种语言的完整示例代码,控制台生成的令牌可直接一键写入 Cherry Studio、AI as Workspace 等客户端。
如何使用 OpenI.One?
官方文档给出的接入路径可以归纳为六步,整体是「先注册拿令牌,再按协议拼地址,最后按返回形态存图」:
- 注册并登录主站。支持邮箱验证注册,登录方式有密码登录与 Passkey 登录两种,注册环节带人机验证;
- 进入控制台创建令牌,并按用途分组。建议按环境(开发、测试、生产)分别建令牌,并只授予该环境真正需要的模型权限;
- 在模型广场挑选模型并确认单价。模型清单与价格需要登录后查看,先确认要用的模型在当前站点处于启用状态,避免调用时遇到 404;
- 按接口类型拼接调用地址。调用地址统一为 https://openi.one,文生图是 POST {BASE_URL}/v1/images/generations,图像编辑是 POST {BASE_URL}/v1/images/edits,Gemini 系列是 POST {BASE_URL}/v1beta/models/{model}:generateContent;
- 处理返回结果。响应为标准的 ImagesResponse,默认优先返回 b64_json,直接 base64 解码落盘即可;如果需要图片链接,可用扩展参数 response_format 指定 url,会按需把 base64 上传到对象存储后回填 URL;
- 长任务改走异步。批量化或高分辨率出图时把地址换成带 ?async=true 的版本,提交成功后拿到 id,轮询任务接口直到状态从 QUEUED/IN_PROGRESS 变为 SUCCESS,再读取 result_url 下载结果图;失败时读 fail_reason。
参数层面有几条硬约束值得先记住:gpt-image-2 的自定义尺寸要求宽高都小于或等于 3840px、都必须是 16px 的倍数、长边与短边比例不超过 3:1、总像素落在 655360 到 8294400 之间;mask 必须与待编辑图尺寸、格式一致并包含 alpha 通道;URL 方式传入的参考图单张上限 20MB、单图下载超时 30 秒、单个请求内最多 5 个并发下载。
OpenI.One的使用场景:
- 同时接多家模型的开发团队:业务里既有图像生成又有对话、推理需求,不想为每家维护一套密钥与 SDK,可以把当统一出口。同类选择可参考站内UniAPI与大模型_API中转站;
- 以图像生成为主的业务:官网把 gemini-3.1-flash-image-preview(快速出图与高吞吐)、gemini-3-pro-image(高质量生成)、gemini-2.5-flash-image(通用生产接入)三个 Gemini 绘图模型列为主推,另提供 gpt-image-2 的 OpenAI 兼容通道,适合商品图、海报、设计稿一类生产场景。图像类工具可直接对比站内ImgAPI;
- 需要批量出图或高分辨率物料的团队:异步任务链路把「提交」与「取结果」拆开,客户端不必长连接等待,适合夜间批量跑图、或需要 4K 级输出的素材生产;
- 对成本与额度敏感的小团队:额度预充值、按模型实际用量结算,配合按模型维度的日志与余额明细,可以逐条对账、及时发现异常调用;
- 个人开发者与快速验证:控制台的令牌可以一键导入常用客户端,站内提供五种语言的示例代码,从注册到跑通第一条请求的路径比较短。如果只是偶尔调用、可用额度有限,也可先看站内讯飞星辰MaaS【免费API】这类带免费额度的选项。
OpenI.One 的价格、计费与额度:
官网没有公开固定价目表,模型广场的内容需要登录后查看,所以这里只说明计费口径,不代填具体数字:额度采用预充值制,按模型与实际用量结算,站内额度以人民币显示,控制台的余额明细与请求日志可按模型、状态和时间维度对账。要拿到准确单价,只能注册登录后在模型广场里逐模型查看。
图像类模型的成本结构在文档里写得很明确,可以据此自行估算:文本输入 tokens、图片输入 tokens、图片输出 tokens 三部分共同决定单次费用。gpt-image-2 对图片输入默认按高保真处理,带参考图或待编辑图的请求会产生图片输入 tokens,成本通常高于纯文生图;quality 越高、尺寸越大、参考图越多,延迟与成本越高。文档给出的建议是先用 quality: “low” 或较小尺寸做草稿生成,确认构图后再提升到 medium 或 high。
还有两条容易被忽略的计费边界:一是异步任务不提供取消接口,任务一旦受理即完成计费结算,批量提交前最好先用少量请求验证参数;二是文档把超过 2560×1440 的输出列为「2K 以上实验性尺寸」,建议先做小批量验证再进入生产流量,避免把调试成本记进正式账单。
OpenI.One的常见问题解答:
- OpenI.One 是模型厂商的官方服务吗?
- 不是。官网免责声明写明「专注提供官方模型调用服务,与各模型厂商为合作接入关系,不对模型内容进行验证,请自行甄别、遵循地区政策使用」。也就是说它处于第三方的位置,模型能力边界、内容合规与地区可用性仍由各上游厂商的条款决定,接入前应自行核对目标模型的授权与使用范围。
- 接入需要改多少现有代码?
- 设计上改动很小。图像生成走 OpenAI 风格的 /v1/images/* 路径,把 SDK 的 baseURL 换成地址即可复用现有 OpenAI 调用代码;Gemini 系列走原生 generateContent,可以用 @google/genai 把 baseUrl 指向 https://openi.one/v1beta。异步场景也只是在原地址后追加查询参数,不需要另写一套任务提交逻辑。
- 调用失败时应该先排查什么?
- 官网给出的顺序是:令牌状态、模型 code、请求参数格式、账户余额,再结合请求日志里的错误信息定位。文档另附完整错误码表可供对照:401 表示未传 Key 或 Key 无效、已过期;403 常见于令牌被禁用、分组未授权该模型,或上游账号未开通所需图片模型权限;404 是模型 ID 不存在或站点未启用该模型;413 是上传图片或 mask 文件过大;429 是触发限流、额度或余额不足;503 是没有可用上游通道或上游临时不可用。排障时把 request id 一起带上,能显著缩短定位时间。
OpenI.One官网网址:
OpenI.One官网入口网址:https://openi.one/
相关页面:模型广场 openi.one/pricing ,控制台 openi.one/dashboard ,接口文档在站内顶部导航的「文档」入口。
同类工具对比
「把多家模型收敛到一个接口下调用」这个位置上的选择不少,差别主要在模型覆盖面、接口形态与信息透明度三处:
- 海外聚合平台:模型覆盖面广、更新快,价格通常按上游加价后透明列示。代价是境内的访问稳定性与付款方式需要自己解决,对以人民币结算的团队门槛偏高;
- 国内 API 中转与:以人民币结算、接入门槛低,是国内团队最常见的路径。选型时重点不是看模型总数,而是核对你真正要用的模型是否启用、图像接口是否支持完整参数。站内APIPASS API Marketplace与Evolink AI Model API属于这一类;
- 单一厂商开放平台:官方直连、文档与 SLA 明确,但只覆盖本家模型,多模型场景仍需再叠一层统一入口,等于的活还得自己做;
- 直接对接上游官方:链路最短、没有中间加价,代价是每家一套密钥与 SDK,遇到 RPM 限制或服务抖动时,重试与降级要业务侧自己写。
放在第三方这一档里看,OpenI.One 的差异点集中在两处:一是图像接口的完整度,它没有把重点放在对话模型的数量上,而是围绕图像生成把 OpenAI Image API 与 Gemini 原生 generateContent 两套协议都铺开到参数级,尺寸约束、mask 要求、参考图下载的安全限制、错误码含义都单独成节;二是异步任务链路,用同一个查询接口收口 GPT 与 Gemini 两个系列的异步任务,并支持幂等键与完成回调,需要批量出图又不想自己维护任务队列的团队能直接用。
它的代价同样清楚:官网没有公开价目表,模型清单与单价要登录后才看得到,对习惯先横向比价再注册的用户不够友好;异步任务受理即计费、不支持取消,也意味着参数调错会直接产生费用。这两点决定了它更适合已经明确模型需求、准备进入生产接入的团队,而不是还在早期比价阶段的个人用户。
OpenI AI时代点评
这个位置的价值不在于多接了几个模型,而在于把上游的不确定性挡在业务代码之外。OpenI.One 官网给出了四个自述指标:请求成功率 99.95%、平均响应延迟 16s、最高可用分辨率 4K、日均调用量 12M+。这些数字能不能在自己的业务形态下复现,必须自己压测才知道,但至少「智能路由、故障自动切换、流量精细化调度」被写成了产品能力而不是宣传口号。对已经在生产里跑图像生成、并且被某一家上游的限流或抖动折腾过的团队来说,中间加这一层是有意义的。
更值得留意的是它把接口规范写到了参数级。尺寸必须是 16px 的倍数、长宽比不超过 3:1、总像素有明确上下限、mask 必须与待编辑图尺寸和格式一致、URL 参考图只允许 http/https 且私有地址一律拒收——这些约束看着繁琐,却恰好是多模型最容易含糊过去的地方。文档还单独标出了「2K 以上算实验性尺寸」「异步任务不受理取消」这类会让用户踩坑的边界,比只给一段漂亮的示例代码要诚实得多。
给几条具体的使用建议:先用低 quality 和小尺寸把链路跑通,再按实际构图逐步提到 medium 或 high;令牌按环境拆分并定期轮换,不要硬编码进客户端;把每次请求的 request id 落进日志,排障时能省掉大量往返;批量任务优先走异步路径,并接受「受理即计费」这条规则——先小批量验证参数,确认无误后再放大并发。
最后要记住它的身份是第三方。官网自己在免责声明里写明不对模型内容进行验证,涉及版权、商用授权与地区政策的判断,最终仍要回到各上游厂商的条款上。把这层关系想清楚再接入,比只看接入文档里的示例代码更重要。
数据评估
本站OpenI提供的大模型API都来源于网络,不保证外部链接的准确性和完整性,同时,对于该外部链接的指向,不由OpenI实际控制,在2026年 9月 23日 下午5:24收录时,该网页上的内容,都属于合规合法,后期网页的内容如出现违规,可以直接联系网站管理员进行删除,OpenI不承担任何责任。
相关导航



全面、高效的AI工具产品情报,发现和使用最酷的AI工具!
Ctrl + D 或 ⌘ + D 收藏本站到浏览器书签栏。