Jev 是什么
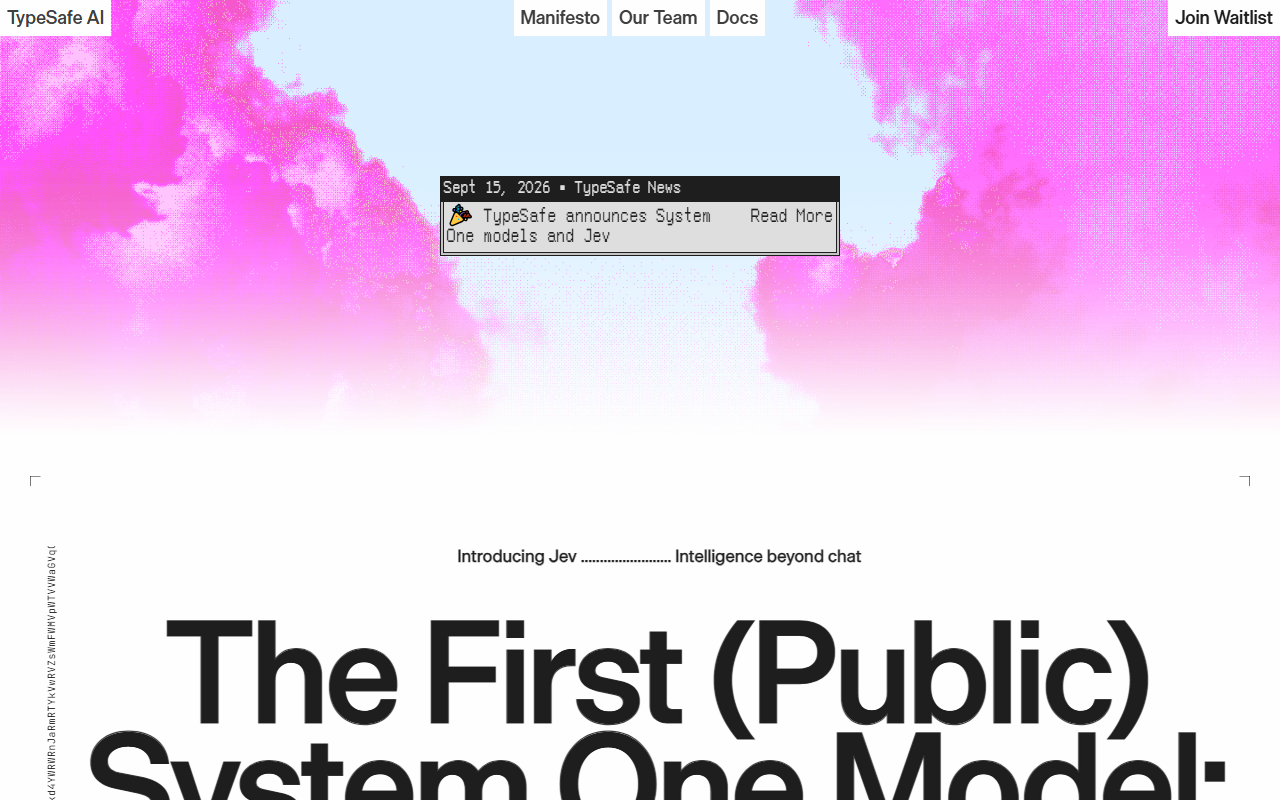 Jev 官网首页(TypeSafe AI)
Jev 是 TypeSafe AI 推出的一款 AI 结构化决策模型。在大模型普遍朝着”无所不能”方向狂奔的今天,Jev 选择了一条截然不同的路:它不陪你,不帮你写代码,也不生成任何一段文字,而是把全部能力收敛到一件事上——高频决策。
具体来说,Jev 接收非结构化信息作为输入,经过一次并行计算,直接输出带有校准概率的结构化判断。整个过程的端到端延迟只有 70 到 500 毫秒,输入成本为每百万 token 0.042 美元,输出完全免费,而类型错误率在数学层面被压到了 0%。这三个指标放在一起,构成了 Jev 区别于所有通用大模型的核心标签。
从产品定位上看,Jev 并不是要替代 ChatGPT 这类对话式模型,而是要补上它们一直缺失的那一环。通用大模型擅长生成,但生成出来的字符串需要被解析、校验、兜底,才能被程序真正消费;而 Jev 从架构上就只产出类型安全的结构化结果,天然可以被代码直接分支、排序和路由。用官方的说法,它更像是 Agent 系统里的一条”前置反射弧”。
需要强调的是,Jev 放弃的是”生成”,换回的是”工程确定性”。它不会给你一段洋洋洒洒的分析,但会在几十毫秒内给出一个带概率的选项、一个评分或者一个布尔判断——而这恰恰是绝大多数自动化流水线真正需要的东西。
理解 Jev 的关键,在于区分两类完全不同的 AI 任务。第一类是”生成型任务”,比如写一封邮件、生成一段代码、回答一个开放问题,这类任务的价值在于内容的丰富度和表达的灵活性,通用大模型是天然合适的选择。第二类则是”判断型任务”,比如这封邮件该不该判为垃圾、这条交易是否存在风险、这个请求应该路由到哪个处理分支——这类任务的数量极其庞大,但每一次的判断本身都很简单,需要的不是文采,而是快速、稳定、可依赖的结论。过去我们只能用生成模型去”模拟”这类判断,代价是要为每次判断付出完整的生成开销,还要承担格式错误的风险,更要命的是即便模型给出了答案,我们也不知道它到底有几分把握。Jev 就是专门为第二类任务而生的:它不去争夺”谁更会说话”,而是把”谁更适合被程序调用”这件事做到了极致。
也正因为定位如此聚焦,Jev 在指标体系上追求的不是”综合能力排名”,而是三个极其工程化的数字:延迟、成本、类型错误率。延迟决定了它能不能被放在系统的关键路径上——如果一次判断要花三秒钟,那它只能出现在离线任务里;成本决定了它能不能被高频调用——如果每次判断要花几分钱,那每用户每天几百次判断的账单就不可承受;类型错误率决定了调用方还需不需要写一堆兜底逻辑——如果需要,那所谓的”自动化”只是把人的工作从判断转移到了修 bug。当这三项同时达标时,AI 判断才第一次真正具备了”当作普通函数调用”的资格,这也是 Jev 反复强调”非结构化输入、结构化输出”这一范式的根本原因。
从使用体验上看,Jev 更像是一个被包装成 API 的判断库,而不是一个”助手”。你不会跟它对话,也不会阅读它给出的长篇解释;你只是把当前的状态丢给它,然后拿回一组可以被 if 语句消费的值。这种体验上的”无感”,恰恰是它面向工程场景设计时最刻意的取舍。
Jev 的主要功能
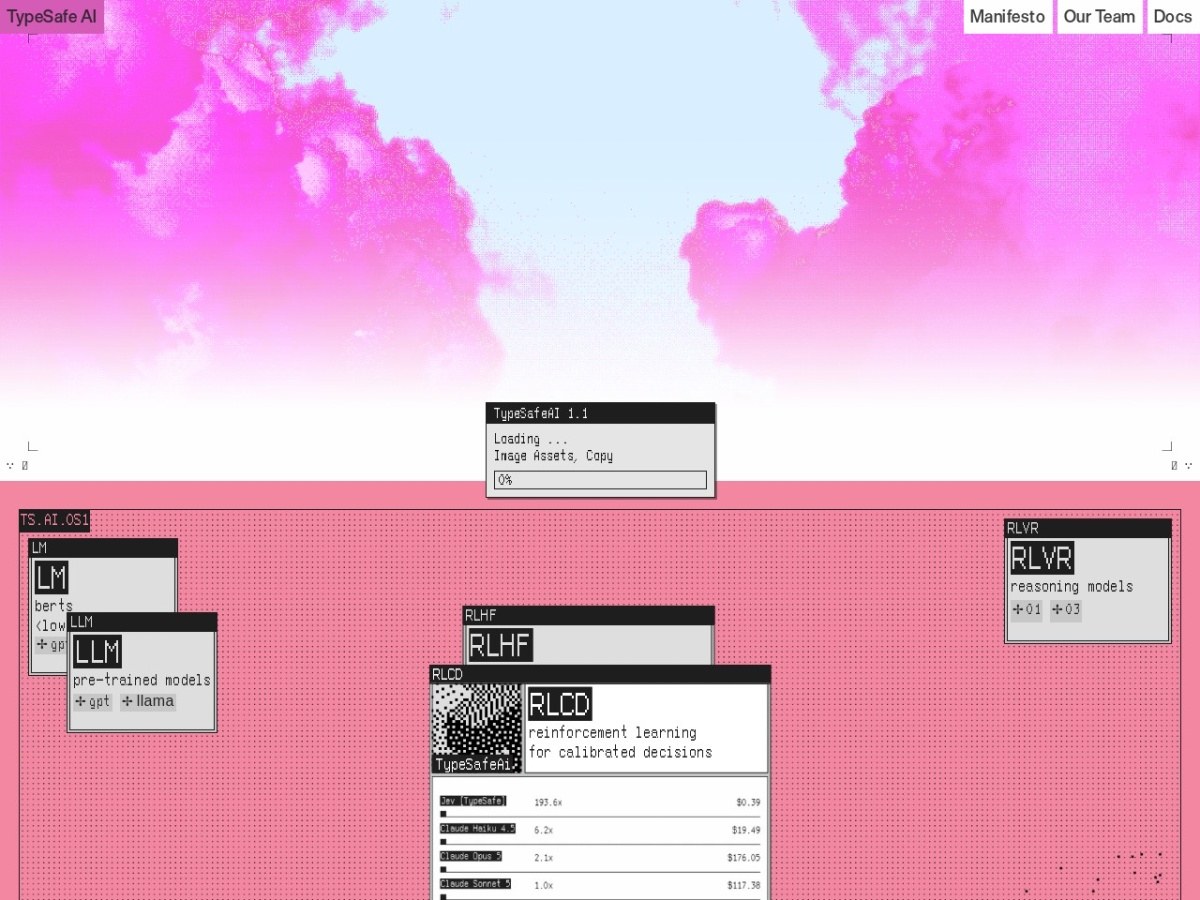 TypeSafe AI 官网对 Jev 技术路线的说明
作为面向 Agent 架构设计的决策层,Jev 的功能设计完全围绕”如何让软件直接消费 AI 的判断”展开。下面按实际使用价值逐条拆解:
- 结构化决策输出:Jev 只返回预先定义框架内的选项、评分或布尔判断,并且每一条结果都附带经过校准的概率值。这意味着调用方拿到的不是需要二次解析的文本,而是可以直接参与逻辑运算的类型化数据。对于工程团队来说,最直观的变化是”再也不用写解析提示词了”——你定义好要什么形状的答案,模型就只会返回那个形状的答案。
- 并行多路判断:单次调用即可同步处理多个彼此的问题,而且延迟不会随着问题数量的增加而线性增长。传统大模型每多问一个问题通常就要多一次生成,问十个问题就要生成十段内容;Jev 则是在一次前向计算里把全部判断一并产出,问题从 1 个增加到 20 个,响应时间的变化微乎其微。这个特性对于需要在一次交互中完成多维度评估的场景尤为关键。
- 置信度分级路由:系统可以根据模型给出的高、中、低置信度自动分流任务——高置信度的结果直接放行进入自动化流程,中等置信度的转人工复核,低置信度的进入兜底逻辑。这让”AI 自动化的边界”第一次变成了可以在代码里配置的参数,而不是靠反复调提示词去试探的玄学。
- 成本大幅压缩:把昂贵的大模型调用开销压缩九成以上。对于那些原本需要调用前沿模型做简单分类的环节,改用 Jev 后成本结构会发生数量级的变化。尤其是输出免费这一条,直接改变了计费模型:你不再需要为了控制成本而绞尽脑汁地精简提示词,也不必担心模型啰嗦几句就烧掉预算。
- 零格式错误保障:类型错误率为 0%,不需要再写正则兜底、重试解析或者”如果解析失败就再问一遍”的容错代码,可以无缝嵌入各类高强度的代码流水线。在实际工程中,这部分被省掉的代码量往往比想象中更多——很多团队的提示词工程里,有一大半篇幅其实是在跟格式问题作斗争。
- Agent 前置:承担路由、分类、风控初筛以及内容过滤等高频决策任务,让前沿大模型从琐碎判断中抽身,专注于真正需要复杂推理的部分。这是一种典型的”分层智能”架构:便宜的模型做宽而浅的判断,昂贵的模型做窄而深的推理,各司其职。
- 多语言 SDK 支持:官方提供 Python 以及 JS/TS 版本的配套 SDK,自动完成底层请求构造与类型校验,显著降低工程落地门槛。前后端团队都能用自己熟悉的语言接入,不需要为了调用一个模型而在技术栈上做妥协。
把这七项能力放在一起看,会发现它们指向的是同一个目标:让 AI 判断变成一种可以被工程化管理的基础设施,而不是每次都需要单独调试的实验性组件。这也是 Jev 与”给大模型套一层 JSON 解析”这类做法最本质的区别。
Jev 的底层技术与创新原理
Jev 之所以能在延迟和成本上形成近乎”降维打击”的效果,根源在于它彻底重构了模型的底层架构,而不是在已有大模型上做裁剪或蒸馏。理解它的技术路线,可以拆成三个层次来看。
第一层,砍掉自回归。传统大模型是一个字一个字往外蹦的,每一个 token 都依赖上一步的结果,这种串行结构天然决定了延迟下限——哪怕模型再小、推理卡再快,生成一百个 token 就是需要一百次前向计算。Jev 采用自研的并行采样器(Parallel Sampler),在单次前向计算中同时产出所有判断结果,彻底摆脱了逐字解码的束缚。这是 70 到 500 毫秒延迟的物理基础,也是它敢把输出定为免费的前提:既然不再逐字生成,输出的边际成本自然趋近于零。
第二层,预先约束输出空间。开发者在使用前需要先定义好 Schema,模型只在限定选项内分配概率。这看起来是”牺牲了绝对度”,但换来的是极致效率——因为模型不需要在无穷的字符串空间里做搜索,只需要在有限候选集上做概率分配。更重要的是,这一机制从原理上根除了格式幻觉:输出空间里根本不存在”错误格式”这种可能。换句话说,不是模型”尽量”不犯错,而是架构上”没有犯错的空间”。
第三层,RLCD 训练方法。也就是 RL for Calibrated Decisions(面向校准决策的强化学习)。它不只优化判断的准确性,还专门校准模型自身的”自信心”。这一点在自动化场景中至关重要:很多模型能做到 95% 的准确率,却说不清自己什么时候会错在那 5% 里,因此无法被真正自动化;Jev 的目标就是让它报出的置信度真实可信——高置信度就意味着高准确率,低置信度就意味着这次判断确实没把握。
把置信度做成标准化接口,是这套技术栈里最工程化的一步。当概率值可信之后,软件系统就可以用阈值做自动化路由:高于某个阈值自动执行,低于某个阈值升级人工。这为构建可靠的 AI 工作流奠定了数学基础,也让”人机协同的比例”第一次变成了一个可以被量化调优的参数,而不是凭感觉设定的流程。
从研究脉络上看,这条路线其实是在回答一个被长期忽略的问题:模型已经很会说话了,为什么自动化落地还是这么难?Jev 给出的答案相当直接——因为”会说话”和”能决策”本来就是两件事,硬用前者去模拟后者,既慢又贵还不可靠。不如从架构层面重新做一件只会决策的东西。
这套组合拳还有一个容易被忽略的副作用:由于所有问题都在同一次调用中并行评估,Jev 天然规避了”上下文污染”的问题。在传统对话模型里,问的问题越多,前面的问答就会越多地干扰后面的判断;而在 Jev 里,每个问题都是地对着同一份状态做评估,问题之间互不干扰。对于需要同时从多个维度给同一份材料打标的场景,这一点带来的稳定性提升非常实在。
当然,架构上的取舍也意味着约束。预先定义 Schema 是零类型错误的前提,但同时也要求调用方在接入前就想清楚”我究竟要问什么”。这其实把一部分原本藏在提示词里的模糊思考,提前逼到了设计阶段——从工程角度看,这未必是坏事,很多线上事故恰恰源于当初没想清楚要模型回答什么。
如何使用 Jev
Jev 目前处于早期访问阶段,接入流程并不复杂,整体可以分为以下几个步骤:
- 申请早期访问:访问 TypeSafe AI 官网加入候补名单,等待审核通过。由于目前仍是早期阶段,建议在项目规划时为接入时间预留一定缓冲。
- 获取凭证:通过审核后,在控制台中创建并获取 API 密钥,妥善保管并做好权限隔离。
- 声明问题与 Schema:在正式调用前,用 JSON 预先声明需要判断的问题,以及每个问题对应的 Schema 类型。这一步决定了模型只能在什么范围内作答,是零类型错误的前提,也是整个接入过程中最需要花心思设计的环节。
- 发起调用:向指定接口发送 POST 请求,将模型 ID 设置为
jev-latest,同时把杂乱的非结构化文本作为输入状态传进去。这里的输入可以是用户留言、日志片段、交易记录或者任何形式的原始文本。 - 接收结果:几乎瞬时就能收获结构化判断与对应的概率分布,直接在代码里分支、排序或路由,无需再做字符串处理。
- 使用官方 SDK:如果不想手写请求,可以直接使用 Python 或 JS/TS SDK,它们会自动完成底层请求构造与类型校验,减少接入期的踩坑成本。
- 配置阈值路由:根据自身业务的风险偏好,为不同置信度区间配置不同的处理策略,把 AI 的判断真正接进自动化流程。建议先用历史数据跑一轮,观察置信度分布,再反过来校准阈值。
实际落地时有两点值得注意。一是问题的拆分粒度:由于 Jev 对多个问题是并行、评估的,把一个大而模糊的问题拆成若干具体的小问题,通常比直接问一个笼统问题得到更可靠的结果,也便于在代码里自行加权组合。二是阈值的设定不要一步到位:先设一个保守的阈值观察一段时间,再根据误判与漏判的实际代价逐步调整。
Jev 的使用场景
毫秒级响应加上极低的单次决策成本,让 Jev 得以进入许多以往通用大模型进不去的实时场景。典型的使用方式包括:
- 内容过滤与推荐预筛:在内容进入推荐池或展示给用户之前,先由 Jev 做一轮毫秒级判断,瞬间剥离无效或违规信息,避免把昂贵的审核资源浪费在明显不合规的内容上。对于内容量级的平台来说,这一层的成本节约往往非常可观。
- 工单路由与客服分流:一封进来的邮件或工单,其紧急程度、应该派给哪个部门、是否存在退款风险,可以在几十毫秒内被一次性厘清,直接进入自动派单流程,既缩短首响时间,也减少人工分发错误。
- 风控与合规初筛:面对海量交易与信贷行为,Jev 可以作为第一道自动化防线,先把明显合规和明显可疑的部分分开,只把模糊地带交给更复杂的模型或人工审核。这种”漏斗式”处理能显著降低整体风控成本。
- Agent 流水线中的高频小判断:工具选择、状态检查、结果排序这类判断在 Agent 执行过程中会出现成百上千次,交给 Jev 承接可以显著降低整体成本与延迟。这也是官方最推荐的用法——把它放在推理链的最前端和各个分叉口上。
- 实时交互场景:凡是用户体验对延迟敏感的产品环节,70 到 500 毫秒的响应意味着 AI 判断可以被放在关键路径上,而不是只能离线跑批处理。这让很多此前因为”太慢”而被放弃的产品设想变得可行。
- 大规模离线数据处理:因为输出免费、输入极便宜,把海量历史数据过一遍做打标或特征提取,成本上第一次变得可接受。对于需要对存量数据做批量结构化处理的团队,这是一个值得评估的选项。
概括来说,凡是满足”判断频次高、单次判断简单、结论需要被程序直接使用”这三个条件的环节,都是 Jev 的适配场景;反之,如果需要模型产出长文本、进行多步推理或者与用户进行开放式对话,那仍然应该交给通用大模型。
同类工具对比
为了更直观地理解 Jev 的位置,下面把它与传统的自回归通用大模型做一个维度对比:
| 对比维度 | Jev | 传统自回归大模型 |
|---|---|---|
| 输出形态 | 预定义 Schema 内的类型化判断,附带校准概率 | 生成的字符串,需解析与校验后才能使用 |
| 端到端延迟 | 70 至 500 毫秒 | 通常数秒到数十秒,随生成长度递增 |
| 成本结构 | 输入 0.042 美元/百万 token,输出免费 | 输入与输出双向计费,输出单价通常更高 |
| 格式可靠性 | 类型错误率 0%,从机制上根除格式幻觉 | 存在格式错误与幻觉风险,需要兜底解析 |
| 置信度 | 每次输出都带经过 RLCD 校准的置信度 | 即便提示要求给出置信度,也常偏于过度自信 |
| 多路并行 | 单次调用并行处理多问题,延迟几乎不增长 | 问题越多生成越长,延迟近似线性增长 |
| 语义通用性 | 保留零样本处理能力,但不生成文本 | 通用性最强,可写作、编码、对话 |
| 适用场景 | 分类、路由、评分、过滤、风控初筛等高频小决策 | 需要生成内容或复杂推理的人机协作任务 |
需要澄清的是,这张表并不是要分出高下,而是说明两者的适用边界。Jev 在语义通用性上明确弱于通用大模型——它不生成任何文字,因此无法承担写作、编码或开放式问答;但在延迟、成本和格式可靠性这三个工程维度上,它面向判断类任务做了彻底的重新设计,优势是结构性的而非调参调出来的。
如果你正在搭建一套 Agent 系统,需要的是”让模型替人做大量重复判断”,那么 Jev 这类决策模型与 ArkClaw智能体、Coze智能体、Trae智能体 这类偏执行与编排的工具体系,恰好处在互补的位置:后者负责”做什么、怎么做”,前者负责在关键分叉口上快速判断”该往哪走”。
Jev 的常见问题解答
- Jev 能写代码或者生成文章吗?
- 不能。Jev 从设计上就不产出任何文字,它唯一的工作是做结构化决策:给定一个状态和一组预先声明的问题,返回选项、评分或布尔判断以及对应的概率。如果你的需求是生成内容,那应该继续使用通用大模型;如果你的需求是让程序在毫秒级做出可依赖的判断,才是 Jev 的用武之地。两者并不冲突,很多团队的实际做法是把它们放在同一条流水线的不同环节上——通用模型负责理解与生成,Jev 负责沿途的高频判断。
- Jev 给出的概率和置信度有什么实际用途?
- 这是 Jev 与普通结构化输出最本质的区别。由于训练阶段使用了 RLCD 方法专门校准置信度,模型报出的高置信度与高准确率是一致的,而不是随口给一个看起来合理的数字。因此你可以在代码里设定阈值:置信度高于阈值的判断自动执行,处于中间区间的转人工复核,低于阈值的走兜底逻辑,从而把 AI 的自动化边界变成可配置的工程参数。实践中建议先用一批有标注的历史数据观察置信度分布,再确定阈值落在哪里,避免一开始就设得过于激进或保守。
- 把 Jev 接入现有系统需要改动很多吗?
- 改动量通常不大。官方提供了 Python 与 JS/TS 两套 SDK,会自动完成请求构造和类型校验,业务侧主要工作是先用 JSON 把要判断的问题和对应 Schema 描述清楚,这部分更多是产品与业务梳理,而非代码改造。对于原本依赖大模型做分类或路由的链路,替换成 Jev 后往往还能顺手删掉一批解析兜底和重试的代码,整体代码量反而会减少。需要注意的是目前仍处于早期访问阶段,需要先在官网加入候补名单并通过审核后才能拿到 API 密钥。
Jev 官网网址
Jev 由 TypeSafe AI 开发,目前处于早期访问阶段,需要前往官网加入候补名单。官方网址为:https://typesafe.ai/。相关技术文档与接入说明可在官网获取。调用时使用的模型 ID 为 jev-latest,配套的 Python 与 JS/TS SDK 也可在官网找到入口。
OpenI AI时代点评
过去两年,行业里几乎所有注意力都投在了”模型能不能更像人一样思考和表达”上,而 Jev 提出的其实是另一个问题:如果模型不需要说给人听,只需要做给程序用,它应该长什么样?TypeSafe AI 给出的答案是——把自回归砍掉、把输出空间锁死、把置信度校准成接口,于是得到了一个 70 到 500 毫秒、输出免费、类型错误率为 0% 的决策引擎。
从工程视角看,最有价值的并不是”快”和”便宜”这两个数字本身,而是置信度可被信任这件事。只要模型能诚实地说出自己有多确定,自动化系统就有了明确的接管边界,AI 才真正从”辅助”走向”可托付”。这也是为什么像 AutoGLM 沉思、天工超级智能体、AI控制电脑(GLM-PC) 这类强调自主执行的智能体产品,未来很可能需要一个类似 Jev 的决策前置层来降低试错成本——自主执行的前提,是每一步判断都知道自己有几分把握。
当然也要看到边界。Jev 放弃了生成能力,这决定了它无法单独承担需要表达或复杂推理的任务;同时它目前仍处于早期访问阶段,生态、文档与最佳实践都还在积累中。在实际架构中更合理的做法是让 发现AI智能体、文心智能体平台 AgentBuilder 这类平台负责编排,让 Qwen Chat、Qwen 3.8-Max 这类通用模型负责生成与推理,而把高频、重复、要求确定性的判断交给 Jev。对正在设计 Agent 流水线的团队来说,TypeSafe AI 官网值得放进观察清单。
相关文章

全面、高效的AI工具产品情报,发现和使用最酷的AI工具!
Ctrl + D 或 ⌘ + D 收藏本站到浏览器书签栏。