Ming-Image-0.1-Design是什么
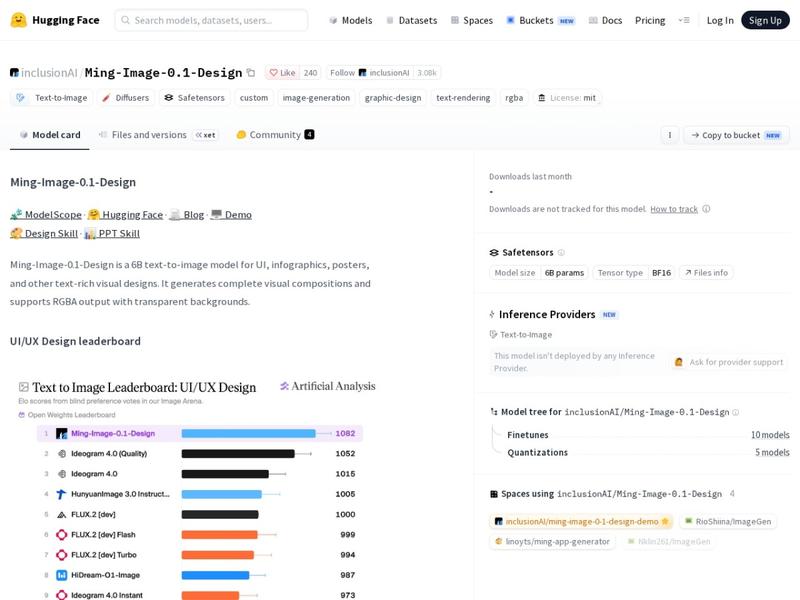 Ming-Image-0.1-Design 在 Artificial Analysis UI/UX 设计榜单登顶
Ming-Image-0.1-Design 是蚂蚁集团旗下 InclusionAI 团队开源的 6B 参数图像生成模型,专注视觉设计领域。它不追求「什么都能画」的通用性,而是把能力集中在 UI 界面、仪表盘、信息图表与海报这类结构化、信息密集的设计稿生成上——模型卡对其定位的描述是:面向 UI、信息图、海报以及其他富文本视觉设计的 6B 文生图模型,能够生成包含标题排版的完整构图,并直接解码为 RGBA 图像。
该系列于 2026 年 9 月正式开源,包含两个参数量均为 6B 的模型:Ming-Image-0.1-Design 负责从文字需求生成完整的视觉设计,Ming-Image-0.1-Design-Layer 负责把创意图或设计图拆解为可编辑的透明图层。模型发布后登顶 Artificial Analysis 的 Text to Image Leaderboard: UI/UX Design 开源权重榜,并已赋能灵光闪应用与画眉等核心业务场景。许可以 MIT 协议开放。
Ming-Image-0.1-Design的主要功能
- 8K 超长结构化提示词支持:模型能够承接长达 8K 的结构化提示词,把庞杂的文字需求直接转化为 UI 界面、仪表盘、信息图表以及海报等成品级视觉稿。
- 文字排版与多区域信息渲染:针对设计稿中大量出现的文字块与多区域信息做了深度调优,保证版式结构稳固、信息层级清晰,而不是出现错字与错位。
- 整体风格一次统筹:模型可以一次性统筹整幅画面的配色、构图与设计风格,避免分次生成造成的视觉割裂感。
- 原生 RGBA 透明背景输出:依托原生 RGBA VAE 架构,模型可直接输出自带透明背景的人物、商品与装饰素材,省去后期抠图环节。官方 Demo 特别说明,透明通道可以完整通过 VAE 往返而不丢失。
- 设计图自动分层:配套的 Layer 模型能把一张设计图拆解为 2 至 9 个语义、边缘洁净的 RGBA 透明图层,并且保证图层重组时高度还原原图。
- 配套 Skill 工作流:团队同步开源了 Design Skill(Ling UI Design)与 PPT Skill(Image to Editable PPT),前者帮助智能体依据提示或截图构建并视觉校验 UI 代码,后者可把生成的一页设计图重建为文本与形状均为原生元素的可编辑 PPT。
Ming-Image-0.1-Design的核心技术创新
- 8K 提示词增强机制:能够把用户的纷繁需求智能梳理为文案、模块、布局与视觉风格四重维度,让长提示词不失控。
- 原生 RGBA VAE:自研的 RGBA VAE 直接开拓了透明通道的生成空间,使模型具备「天生带 Alpha」的输出能力。
- Type Token 图层角色约束:Layer 模型通过类型标记约束每个图层在设计稿中承担的角色,避免图层语义错乱。
- Alpha-Aware 边缘优化:针对透明边缘做专门优化,减少抠图常见的毛边与半透明杂色。
- Composite-Layer Stack Consistency:引入重组一致性约束,确保拆解出的图层重新叠加后与原图高度一致,而不是「拆得开、拼不回」。
Ming-Image-0.1-Design如何使用
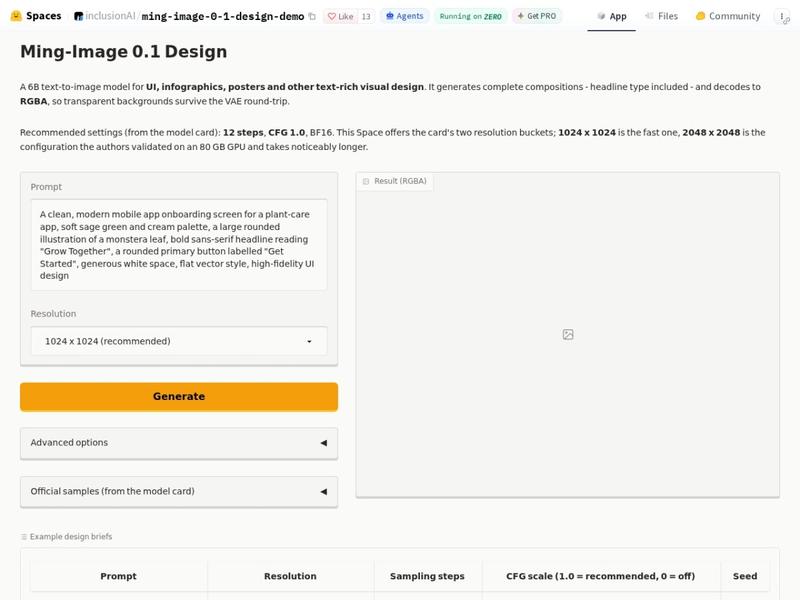 官方在线 Demo:输入设计需求提示词即可生成,默认 1024×1024
- 在线试用:开发者可通过 OpenRouter 的免费 API 直接调用(https://openrouter.ai/inclusionai/ming-image-0.1-design),或使用 Hugging Face 上的官方 Demo Space 零门槛体验。
- 获取模型权重:前往 Hugging Face 获取 https://huggingface.co/inclusionAI/Ming-Image-0.1-Design 与 https://huggingface.co/inclusionAI/Ming-Image-0.1-Design-Layer,国内用户也可从 ModelScope 下载同名模型。
- 写清设计需求:提示词尽量描述清楚版面结构、模块划分、配色与风格。官方 Demo 给出的示例是一条完整的英文设计 brief,涵盖页面用途、配色、插画内容、标题文案与按钮文字。
- 设置推理参数:官方推荐配置为 12 步采样;文生图任务 CFG 取 1.0,图层分解任务 CFG 取 2.0。分辨率提供 1024 与 2048 两档桶,1024×1024 速度最快,2048×2048 为经过验证的高质量配置但耗时更长。
- 图层分解:切换至 Layer 模型后,指定需要的图层数量(2 至 9 层),模型会返回各图层;CLI 会自动跳过前置的合成图,按顺序保存为 PNG。
- 本地部署:默认验证配置为单张 GPU、至少 80 GiB 显存、以 BF16 精度运行,推荐搭配 vLLM-Omni 推理框架,运行环境需 Python 3.10 及以上。
Ming-Image-0.1-Design的使用场景
- AI 应用的视觉预览:在产品立项阶段快速产出 UI 概念稿,把讨论从文字描述推进到可视化方案。若只需要通用风格的配图,也可以参考 豆包图像生成 这类通用文生图工具。
- 专业设计稿的图层二次编辑:拿到设计图后通过 Layer 模型拆层,再在常规设计软件中逐层调整,省去手动分层的重复劳动。
- 前端页面的智能还原:配合 Design Skill,智能体可以依据生成的视觉参考与图层分解结果,构建并对 UI 代码做视觉自检。
- PPT 幻灯片快捷复刻:借助 PPT Skill,把生成的一页设计稿还原为文本与形状都可编辑的原生 PPT 元素。
- 信息图与数据看板:面向信息密集的图表与仪表盘场景,模型对多区域信息的渲染能力可以直接产出可用的版式。
- 透明素材生产:电商主图、海报装饰元素等需要抠图的素材,可以直接用 RGBA 输出,跳过抠图流程。
- 模型选型对比:在评估开源图像生成方案时,可与 Flux.2 AI 图像生成器、腾讯混元图像 2.0 等条目一并纳入候选,按设计稿专项能力与推理成本做取舍。
Ming-Image-0.1-Design与同类模型对比
在 Artificial Analysis 的 Text to Image Leaderboard: UI/UX Design 开源权重榜单中,Ming-Image-0.1-Design 以 1082 的 Elo 分数位列第一,高于 Ideogram 4.0(1052)、HunyuanImage 3.0 Instruct(1005)与 FLUX.2 [dev](1000)。值得注意的是,它是在 6B 参数量级下取得这一成绩的:在仅有 6B 参数的前提下,其推理速度比 20B 的 Qwen 开源版快出 4.3 倍,工程优化后的完整响应时间缩短至 20 秒左右,并在 Crello-Test 的 12 项指标中全部斩获第一。
| 对比维度 | Ming-Image-0.1-Design | 通用文生图模型(如 20B 级开源模型) |
|---|---|---|
| 参数量 | 6B | 20B 级别 |
| 推理速度 | 比 20B Qwen 开源版快 4.3 倍,完整响应约 20 秒 | 参数更大,单次推理耗时更长 |
| 能力侧重 | UI、仪表盘、信息图、海报等结构化设计稿 | 通用题材图像,风格覆盖广但版式控制弱 |
| 长提示词 | 支持 8K 结构化提示词,自动梳理为四重维度 | 长提示词易失控,信息密度难以保证 |
| 透明背景 | 原生 RGBA VAE,直出带 Alpha 的素材 | 多数需依赖外部抠图工具后处理 |
| 可编辑性 | 配套 Layer 模型拆解为 2 至 9 个图层 | 输出通常为单张扁平图,难以分层编辑 |
| 风格一致性 | 一次性统筹配色、构图与风格 | 多次生成容易出现视觉割裂 |
| 开源许可 | MIT 协议,权重在 Hugging Face 与 ModelScope 开放 | 各模型许可不一,商用条款需逐一确认 |
Ming-Image-0.1-Design的常见问题解答
- Ming-Image-0.1-Design 可以商用吗?
- 该系列以 MIT 协议开源,权重同时在 Hugging Face 与 ModelScope 开放下载,商用条件相对宽松。不过生成内容本身的合规责任仍由使用者承担,建议在正式商用前确认所在地区的相关要求。
- Ming-Image-0.1-Design 和 Ming-Image-0.1-Design-Layer 有什么区别?
- 前者是文生图模型,负责从文字需求生成 UI、信息图、海报等完整视觉设计;后者是图层分解模型,负责把已有的设计图或创意图拆解成 2 至 9 个可编辑的 RGBA 透明图层。两者参数量均为 6B,配合使用可覆盖「生成—分层—编辑—交付」的完整流程。
- Ming-Image-0.1-Design 需要什么硬件才能跑起来?
- 官方给出的默认验证配置为单张 GPU、至少 80 GiB 显存,并以 BF16 精度运行,运行环境需要 Python 3.10 或更新版本。如果只是体验效果,使用官方在线 Demo 或 OpenRouter 的免费 API 即可,无需自备算力。
Ming-Image-0.1-Design官网网址
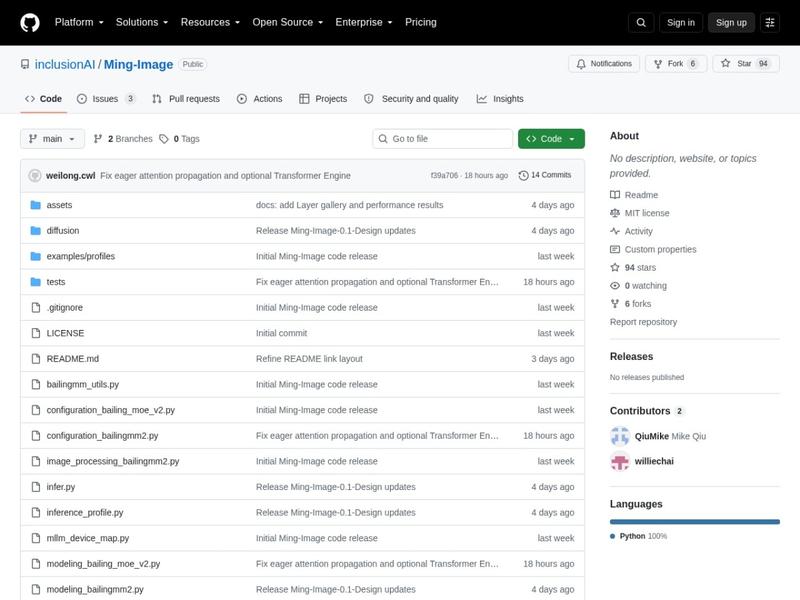 Ming-Image 开源仓库:MIT 协议,含推理脚本与配套文档
模型权重与使用文档:https://huggingface.co/inclusionAI/Ming-Image-0.1-Design;图层分解模型:https://huggingface.co/inclusionAI/Ming-Image-0.1-Design-Layer;在线 API 试用:https://openrouter.ai/inclusionai/ming-image-0.1-design。
OpenI AI时代点评
Ming-Image-0.1-Design 最值得关注的不是榜单名次,而是它选择的方向:把「设计稿」当成一类的生成目标,而不是通用文生图的一个子集。结构化排版、多区域信息渲染、RGBA 透明输出、可分层编辑,这四件事恰恰是通用模型最难兼顾的部分——通用模型擅长画得好看,但很难画得「能用」。对于要拿图去落地做界面、做信息图、做前端还原的团队来说,可用性比观感重要得多。
另一个关键点是 6B 的体量。在 6B 参数下取得 UI/UX 开源榜第一,同时推理速度比 20B 级开源模型快 4.3 倍、完整响应压缩到 20 秒左右,意味着它的部署成本与响应延迟都更接近工程可用的区间;再叠加 MIT 协议与配套的 Design Skill、PPT Skill,整条「生成—分层—编辑—交付」的链路是完整交付的,而不是只给一个权重。对于关注 AI 设计工具落地的团队,可以通过 https://huggingface.co/inclusionAI/Ming-Image-0.1-Design 或 ModelScope 获取权重后自行验证。若只想先看效果,也可以横向对比 AI Image Generator 与 AI图像编辑器 等通用方案,再判断专项模型是否更契合自己的场景。
相关文章

全面、高效的AI工具产品情报,发现和使用最酷的AI工具!
Ctrl + D 或 ⌘ + D 收藏本站到浏览器书签栏。