LibTV 1.5 是什么
LibTV 1.5 是 AI 视频创作平台 LibTV 近期推送的一次重量级版本更新,官方入口为 https://www.liblib.tv。它面向的是真正需要把一部片子从零做到交付的创作者:从最初的灵感碰撞与剧本推演,到人物造型、分镜切片、镜头调度,再到最后的封面包装与成片剪辑,LibTV 1.5 试图把整条工业化生产链路收进同一个工作台里跑完。
现在随便刷刷各大视频平台,首页总能刷到一两条 AI 生成的爆款内容,AI 短剧的热度已经不需要再论证。但真正动手做过 AI 短片的人都清楚,从”我有个想法”到”片子能发”,中间要踩的坑数不胜数:剧本写不圆、角色长相前后不一致、分镜提示词写到头秃、镜头调度永远差一口气、成片没有封面不够吸睛。这些坑不是靠某一个模型变强就能自动消失的,它们属于流程问题,只能靠工具链的迭代来填。
LibTV 1.5 这次的更新正是冲着这几处痛点来的。新版本支持对角色的面部轮廓、发型乃至衣着做精细调整;剧本想改某句台词时可以做局部修改;同时还加入了导演分身、3D 虚拟影棚以及成片精修三项硬核能力。光看功能列表其实感受不到差别,所以我这次直接拿它跑了一部完整的现代修仙题材短剧,把整个流程从头到尾走了一遍,下面记录的都是我实际点过的路径。
 LibTV 1.5 工作台界面,剧本、角色与分镜在同一画布上串联
LibTV 1.5 的主要功能
- 剧本原创与局部改写:入口在画布正下方的 TV Director 模块,可从爆款预设切入,选择题材(甚至支持双题材融合),并自定义受众群体、人设细节与故事背景,由系统引导产出结构完整的剧本;后续想改动某句台词或某处剧情冲突时支持只改局部,并会提示该改动对前后伏笔的影响,由创作者决定是否联动调整。
- 角色造型室:可从原始人设、参考图片或已有角色出发,对五官、发型、服装做可视化精细调整,连面部微小的痣、雀斑、疤痕都能单独拿捏,而不必整体重新生成。
- 角色卡归档:确认满意的视觉形象后可一键存为角色卡,做第二集、第三集时直接调用,不必每次开新集都重新描述一遍主角长什么样。
- 导演执导(导演分身):选定一种视觉风格后可全程复用,也能调配出自己的美学风格;设定妥当后指派导演一键生成整集分镜,并自动撰写与批量优化提示词。
- 3D-BOX 虚拟影棚:用自然语言对话让 AI 自动搭出对应的三维模型,并规划好镜头轨迹,用来解决人物站位复杂、空间关系难以用文字描述、运镜到不了理想机位的问题。
- 成片精修与创意片头:从视频中挑一帧作底图,为短片拟定片名并选择视觉风格(也支持深度自定义),快速生成吸睛封面;还可以进一步添加动效,把静态封面变成动态视觉片头。
把这五类能力放在一起看,分工其实相当清楚:剧本原创解决”想不出来”,角色造型室解决”生成得不够准”,导演分身解决”分镜写不过来”,3D 虚拟影棚解决”运镜说不清”,成片精修解决”发出去没人点”。它们正好对应一部片子从构思、塑造、切片、调度到包装的五个环节,彼此咬合在一起,而不是五个各自为政的按钮——这也是这次升级最值得注意的地方。
如何使用 LibTV 1.5
- 从 TV Director 起故事:在画布正下方进入 TV Director 模块,选择从爆款预设切入,挑选题材、受众、人设与故事背景,先生成故事大纲。
- 让智能助手写分集剧本:大纲确认后交给智能助手继续推进,直接产出第一集的剧本内容,期间几乎不需要手动干预。
- 用全能创作生成角色:点击全能创作按钮,让 AI 把这一集所需的人物一次性呈现出来。
- 进角色造型室做微调:点击画布下方的角色造型室,针对发型、五官、服装做定点修改,其余元素保持原样。
- 指派导演生成分镜:先定好视觉风格,再让导演一键生成整集分镜,我这次拿到的是 13 个分镜视频节点。
- 复杂场景切到虚拟影棚:遇到前后场景不连贯、运镜轨迹不符合预期的镜头,用自然语言让 3D 虚拟影棚搭模型、定机位。
- 逐条渲染与剪辑:依次把每个视频片段渲染出来,再让智能助手把素材无缝剪辑到一起。
- 做片头、拼成片:选中视频点击创意片头,挑帧、起名、选风格生成封面,可加动效,最后与正片拼接导出。
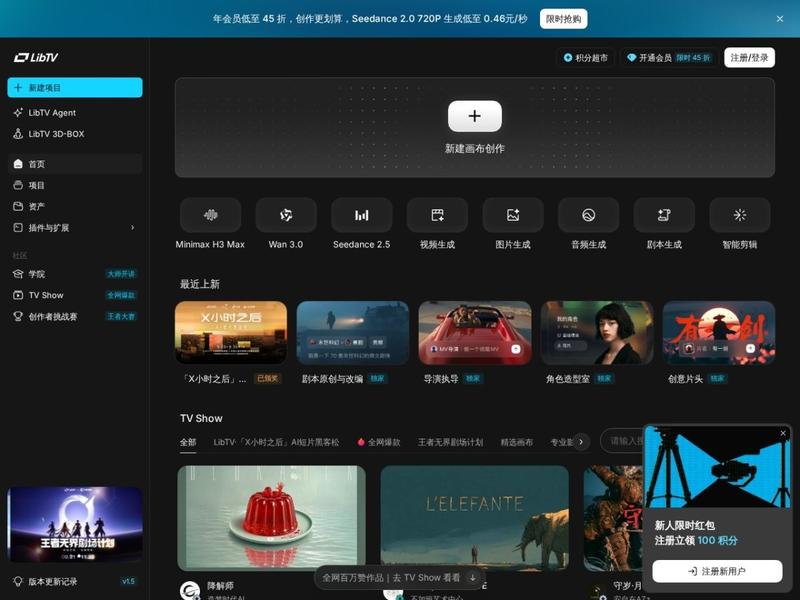 用自然语言在 3D 虚拟影棚中搭建场景并规划运镜轨迹
LibTV 1.5 实测记录:一部现代修仙短剧是怎么跑完的
我这次定的题材是现代修仙,核心设定大致是这样:天地间的灵气总量恒定,修士吸收的灵气唯有在其陨落或飞升后才会回归自然;远古蓝星本可修仙,奈何灵气被诸位大能贪婪吞噬,而这些前辈无一人成功飞升反哺天地;唯有高阶修士坐化时灵气才短暂回归,很快又被瓜分。直到世间只剩最后一位化神期大修士,蓝星残存灵气理论上已足够滋养大批修仙者,可这位修士直至 2050 年黯然离世也没能叩开飞升之门,蓝星灵气由此迎来彻底复苏。时间来到 2100 年,人间再度涌现无数修行者。主角叶晨本是个普通打工族,机缘巧合捡到一块藏有仙界无上的上古玉石,自此开启逆袭之路;一路修炼至化神期后,他发现通往仙界的飞升通道竟被人蓄意截断,最终凭实力强行轰碎阻碍,成功飞升仙界。
值得一提的是剧本原创的入口设计:它位于画布正下方的 TV Director 模块里,从爆款预设切入后可以选择题材,甚至支持双题材融合,受众群体、人设细节与故事背景都能单独定义。也就是说,”现代 + 修仙”这种混搭不是靠我在提示词里硬凑出来的,平台本身就把题材组合做成了一个可选参数。
把这套设定丢进去后,LibTV 先给出了自动整理的故事大纲,接着由智能助手推进生成了第一集剧本。整个过程我只提供了上面这些基础设定与剧情框架,没有额外手写任何台词。下一步是人物塑造,点击全能创作后,第一集需要的角色被逐个呈现出来。
这里正好碰到 AI 视频创作最典型的一个坎:自动生成的角色大体过得去,但局部细节总差一口气,而一旦选择整体重新生成,往往是好了这处又坏了那处。我这次的处理方式是只给男主角叶晨换个利落的寸头——进角色造型室单独改发型,改完之后体态、衣着这些核心元素都完整保留了下来。这种”只动该动的地方”的能力,比重新抽卡十次都实用。
分镜阶段是导演分身的活。我定好风格后指派导演一键生成,最终拿到 13 个分镜视频节点。不过预览时我发现,部分复杂度较高的场景直接生成容易出现前后不连贯,运镜轨迹也没完全贴合预期。对熟悉 AI 视频制作的老手来说,做个 3D 建模就能解决,但不会建模的人怎么办?这就是 3D 虚拟影棚登场的原因——我用自然语言描述想要的场景,它直接搭出了三维模型并规划好镜头,我只要看一眼模型和运镜表现是否对味即可。
之后的工作变得很机械:逐条渲染视频片段,再让智能助手把所有素材无缝剪辑到一起。成片出来后我注意到一个很现实的问题——没有吸睛的封面和片名字幕,直接发出去很难让人点开。于是选中视频点击创意片头,从片中挑一帧作底图,起了个片名,选了中式书法风格,封面就出来了;系统还提示可以进一步加动效,把静态封面变成流转的动态片头。最后把片头与正片拼接,一部完整短片就此收工。
LibTV 1.5 的使用场景
- 短剧工作室的连续产出:需要持续高频出片、且要保证角色与场景跨集一致,角色卡归档与资产复用能省掉大量重复描述的工作量,明显减少返工。
- 商业广告与品牌宣传片:从创意到分镜、运镜、成片包装一条链路完成,交付周期可控,客户临时提修改意见时也能做局部调整而不是整条重做。
- 电商内容孵化:需要批量产出、且对成片包装(封面、片名、动效)有要求,创意片头这类收尾功能直接关系到点击率表现。
- 个人创作者的第一次尝试:手头只有一个模糊点子也没关系,剧本原创会从题材、受众、人设一路引导到完整剧本,门槛主要在”想讲什么”,不在”怎么用工具”。
- 复杂调度的镜头预演:人物站位错综复杂、空间关系难以用文字描述时,先用 3D 虚拟影棚搭模型、定机位,再交给视频模型生成,比反复改提示词高效得多。
回头看这次升级,它真正改善的其实是三个可以被量化的维度:修改的便捷程度、资产复用的效率,以及做一部片子需要投入的人力。前两个维度在单条短片上体现得并不明显,但只要项目一旦变成系列、变成需要持续交付的生意,差距就会被迅速放大。
在规划自己的视频工具组合时,也可以横向看看同类产品:偏重素材与画面生成的创作者可以留意 绘蛙 AI 生图与视频,侧重国产视频模型能力的可以关注 通义万相 AI 视频,预算敏感、想先跑通流程的则可以从 免费 AI 生成视频 这类入口入手;而长期以 LibTV 为主要工作台的团队,也不妨对照 LibTV 的早期条目,看看这个产品一路迭代了哪些能力。
LibTV 1.5 的常见问题解答
- LibTV 1.5 适合完全没有视频制作经验的新手吗?
- 适合。剧本原创模块会从题材、受众群体、人设细节到故事背景一路引导,只需输入一个初步想法就能生成结构完整的剧本;分镜、角色、渲染、剪辑也都由系统接管,新手的主要门槛在于”想讲一个什么故事”,而不是软件操作。
- 角色调整好了,做第二集、第三集时还要重新描述吗?
- 不需要。确认满意的视觉形象后可以一键归档为角色卡,后续剧集直接调用即可。这样既省掉重复描述容貌的流程,也保证了系列作品里角色形象前后的高度一致。
- 不会 3D 建模,能用虚拟影棚吗?
- 可以。3D-BOX 虚拟影棚的设计前提就是”不会建模也能用”:用自然语言对话描述场景,AI 会自动搭建对应的三维模型并规划镜头轨迹,创作者只需要判断生成结果是否符合预期。
LibTV 1.5 官网网址
OpenI AI时代点评
跑完这一整轮,我更愿意把 LibTV 1.5 理解成一个以项目为核心驱动的 AI 视频协同工作台,而不是又一个”输入提示词出几秒视频”的生成器。它的五项核心能力——剧本原创、角色造型、导演分身、3D 虚拟影棚、成片精修——正好分别对应剧本构思、人物塑造、分镜规划、运镜调度与后期包装五个环节,彼此是扣在一起的,而不是五个孤立的功能按钮。
如今各家 AI 视频平台的竞争,早已从单点画面质量的比拼,演变为整套工业化制作链路的较量。创作者挑选工具时考虑的因素正在变多:画面精细度、修改便捷程度、资产复用效率,以及做一部片子到底要投入多少人力和时间。从这个角度看,LibTV 1.5 真正有价值的不是某一帧生成得多好看,而是角色资产能长久保存、运镜逻辑能沉淀复用、瑕疵片段能精准锁定并局部修改——这些对需要持续交付的团队来说,是能直接换算成成本的东西。
还有一个容易被忽略的点:修改的粒度。传统做法里,改一句台词往往意味着重跑一遍剧本,改一个发型往往意味着重新抽十次卡。而在 LibTV 1.5 里,剧本支持局部微调、并会提示该改动对前后伏笔的影响,角色支持只改五官、发型或服装中的某一项。修改的粒度越细,返工的成本就越低,这对需要承接客户意见的团队尤其重要。
项目规模越大,数字资产的稳定性与复用性就越重要,它决定了团队要花多少时间重新描述人物特征、核对画面连贯性、处理前后视觉不一致。第一集杀青后,第二集能否无缝继承原有的角色与场景资产,面对客户不断冒出来的修改意见能否尽量少返工,最终交付成本是否划算——这些才是工作室愿不愿意长期留在这里、并把更多核心项目迁移过来的关键动力。感兴趣的话,可以直接到 LibTV 官网 上手试一遍自己的题材。
相关文章

全面、高效的AI工具产品情报,发现和使用最酷的AI工具!
Ctrl + D 或 ⌘ + D 收藏本站到浏览器书签栏。