

Warning: Invalid argument supplied for foreach() in /www/wwwroot/openi.cn/wp-content/themes/onenav/inc/functions/io-single-app.php on line 367
Warning: Invalid argument supplied for foreach() in /www/wwwroot/openi.cn/wp-content/themes/onenav/inc/functions/io-single-app.php on line 367
Warning: Illegal string offset 'app_version' in /www/wwwroot/openi.cn/wp-content/themes/onenav/inc/functions/io-single-app.php on line 158
Warning: Illegal string offset 'app_status' in /www/wwwroot/openi.cn/wp-content/themes/onenav/inc/functions/io-single-app.php on line 165
Warning: Illegal string offset 'app_ad' in /www/wwwroot/openi.cn/wp-content/themes/onenav/inc/functions/io-single-app.php on line 166
Warning: Illegal string offset 'app_date' in /www/wwwroot/openi.cn/wp-content/themes/onenav/inc/functions/io-single-app.php on line 172
Warning: Illegal string offset 'app_language' in /www/wwwroot/openi.cn/wp-content/themes/onenav/inc/functions/io-single-app.php on line 174
Warning: Illegal string offset 'index' in /www/wwwroot/openi.cn/wp-content/themes/onenav/inc/functions/io-single-app.php on line 282
Bevel 是什么:把可穿戴设备的数据翻译成一句人话
Bevel 是一款 iOS 端的 AI 健康教练应用,在 App Store 中国区的全名是「Bevel: AI健康教练」,开发者一栏写着 Starlight Tech LLC。它做的事情可以一句话概括:把你手腕上那块表已经记下来的睡眠、心率、心率变异度和训练负荷,折算成几个百分数,再加一句当天该练还是该歇的建议。
打开首页,最先看到的是三个环。截图里的日期是「今天,9月12日」,三个环分别是恢复 40%、睡眠 41%、应变 75%。三个数字下面是一段机器写的话,大意是「你昨晚只睡了5小时,深度睡眠和HRV数值偏低……恢复一般」。再往下是「压力与能量」区块,当前压力显示 24,标注「低」。
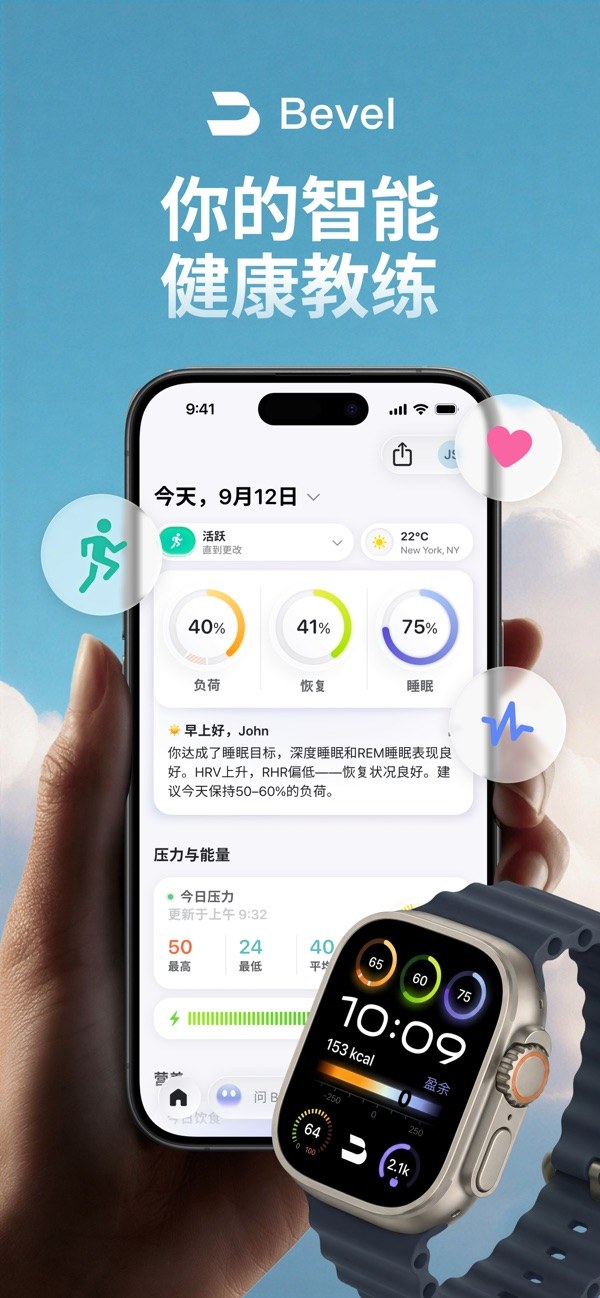
首页把三个环并排放在最上方,下面紧跟一段 AI 生成的当日点评,再往下才是「压力与能量」的实时数值。
这一段点评其实是整款产品的缩影。它没有停在「你睡了 5 小时」这种复述层面,而是把时长、深度睡眠比例和 HRV 三个信号串起来,给了一个「恢复一般」的判断。这个判断值不值得信,后文会专门拆。先把事实摆清楚。
Bevel 首次上线是 2024 年 1 月 8 日,当前版本 v3.2.6,最近一次更新在 2026 年 10 月 29 日。商店分类挂在「健康健美」与「体育」下,年龄分级 12+,最低要求 iOS 18.0,安装包约 916 MB。下载免费,核心功能需要订阅,具体价格官方页面未在可核验范围内公开,本文不作猜测。
评分方面,中国区 4.82 分、347 个评分,美国区 4.85 分、17,563 个评分。两个市场的样本量差了五十倍,美国区那个数字更接近真实口碑;中国区 347 个样本还太小,一次版本波动或者一场推广就能把分数拉偏几分。看到高分先看样本量,这是判断任何一款 App 口碑的基本功。
还有一个细节值得提一句:它的包名是 com.supersethealth.superset,和现在的中文名对不上。这个名字来自产品的前身 Superset,改名之后工程标识沿用了下来。这一点只作为背景提示,官方并没有正式说明过更名的经过,所以不宜据此推断产品的历史沿革。
它卖的是「教练」,不是「记录本」
健康类应用大致分两层。下面一层是记录:步数、心率、睡眠时长,把数据画成图表。上面一层是解释:这些数字意味着什么,明天该做什么。苹果自带的「健康」把第一层做得很好,免费、系统级、数据最全,但它极少告诉你「今天别练了」。
Bevel 切的是第二层。它的首页不给你看原始曲线,直接给结论。这个选择有代价——结论可能是错的,而用户看不出错在哪。所以它的产品里保留了「深入探索」的入口,点进去能看到各项指标的计算依据和原始数据。这种「先给结论,再给论据」的信息层级,比一上来就丢二十张图表要友好得多,但也要求用户对结论保持一点怀疑。
从截图上能读到的四句官方文案,基本就是产品的四条主线:「你的智能健康教练」解释自己是谁,「适配你的所有可穿戴设备」说明数据从哪来,「深入探索 Bevel 智能」展示 AI 能干什么,「创建训练计划」落到具体执行。四句话对应四个用户疑问,文案写得相当克制。
数据来源这一条尤其重要。Bevel 自己不生产硬件,官方截图里列出的兼容来源有 Apple Watch、GARMIN、OURA、amazfit 和 Google Health 五类。
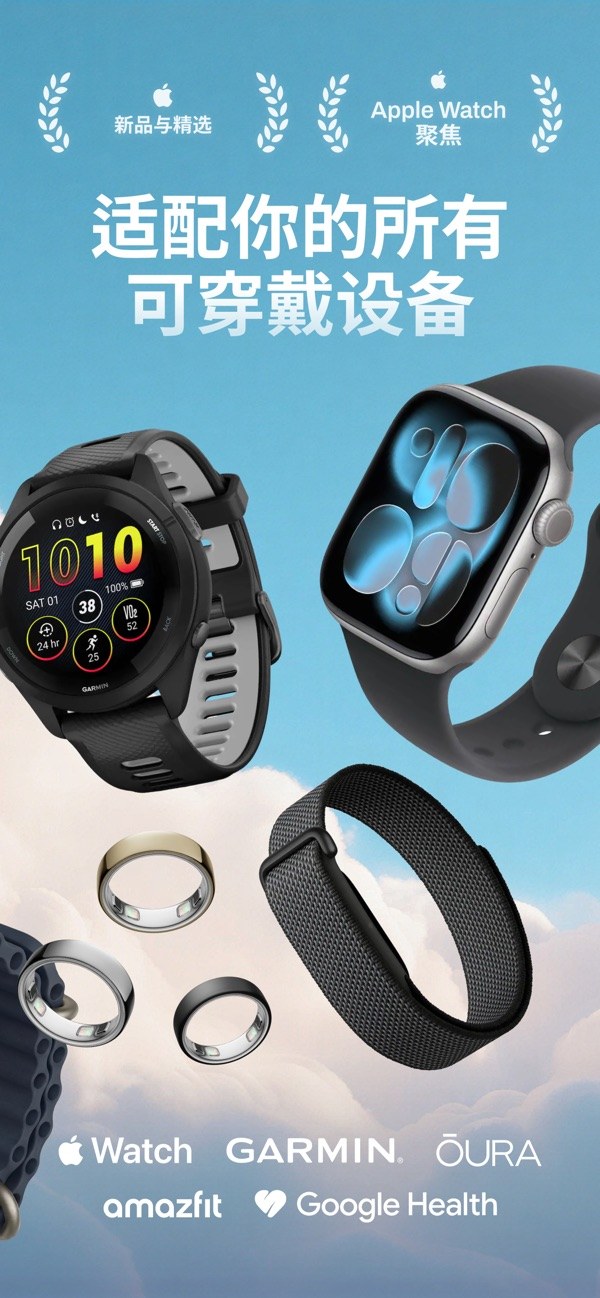
五类设备与平台并排放在一张图里,等于直接说明了它的定位:不做硬件,做的是硬件之上的那一层分析。
界面上的信息密度
Bevel 的视觉风格偏冷,大量使用环形进度和留白,单个屏幕上的信息点不超过五个。这不是审美偏好,是使用场景决定的——健康数据大多是早上起床时看一眼,看的时间不超过三十秒,信息越少越容易形成习惯。
代价是深度信息被折叠了。想看某一晚的睡眠结构、想看某次训练的配速分布,都得再点两三层。对愿意钻研的人这不算问题,对只想扫一眼的人反而是好事。它把「每天早上看一眼」当成核心动作来设计,而不是把「周末做一次数据分析」当成核心动作。
主要功能:九项能力逐条拆
官方列出的功能有九项,从 AI 引擎到日志,覆盖了「读数据—给建议—排计划—记饮食—记习惯」的完整链路。这一节逐条过一遍,重点说清楚每一项在什么场景下有用、边界在哪。
一、Bevel Intelligence:把九个模块串成一个对话
Bevel Intelligence 是这套产品的智能健康引擎,官方的说法是「连接数据点,给出即时反馈与个性化建议,帮你决定何时训练、何时休息」。翻成日常语言:它是整个 App 的大脑,其他八个模块往里喂数据,它往外吐判断。
它最重要的形态是。截图里能看到界面顶部写着「欢迎回来,John!」,下面两个快捷入口——「创建训练计划」和「记录饮食」,底部输入框写着「向 Bevel 任性提问」。
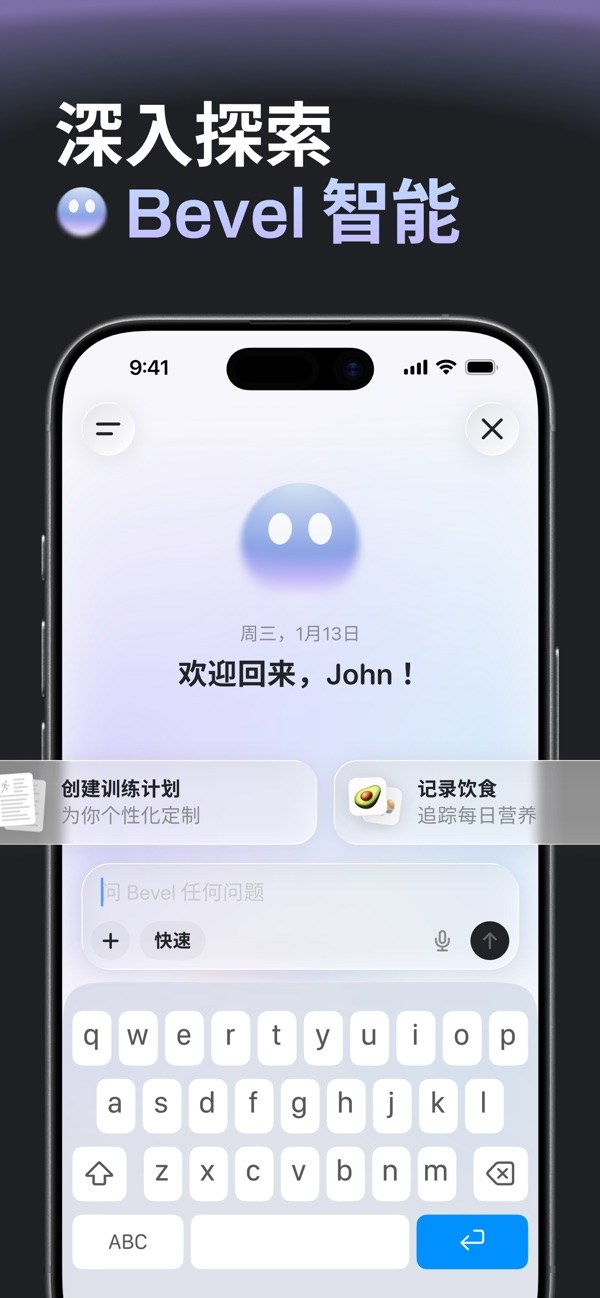
页把最高频的两个动作做成了按钮:排训练计划、记一顿饭。输入框的提示语写得很口语,暗示用户可以用自然语言提问。
把入口做成「提问」而不是「选项」,好处是门槛低,坏处是答案质量高度依赖提问质量。你问「我今天该练什么」,它会给你一个笼统的方案;你问「我昨天做了 8 组深蹲,今天大腿还在酸,晚上想跑 5 公里,配速控制在多少合适」,它才可能给出有用的答案。这类产品的能力上限,很大程度上由用户会不会提问决定。
v3.2.6 给这个模块补了两件事:一是应用内通知,Bevel Intelligence 可以主动推送提醒,不用你每次主动去问;二是工具栏与动画的改进。主动推送这一步挺关键——教练的价值有一半在「催」,不催的教练只是笔记本。
二、恢复分数:每天一个「今天能练多狠」的答案
恢复分数(Recovery Score)把当天的准备情况压缩成一个数字,官方定位是「简化每日准备情况,避免过度训练与受伤」。截图里它是 40,属于明显偏低的区间,配合那段「只睡了 5 小时」的点评,逻辑是自洽的。
这个数字的用法不是「及格线」,而是「和自己比」。40 分本身没有意义,有意义的是「我这周的平均是 62,今天 40,掉了 22 分」。掉分的原因可能是前一晚喝酒、可能是连续三天高强度、可能是感冒前兆,也可能是手表戴松了、夜里翻身太多导致信号不良。
产品把它放在三个环的第一个位置,说明它是整个首页的叙事起点:先告诉你还剩多少余量,再告诉你昨晚睡得怎样,最后告诉你今天承受了多少。顺序本身就是一种观点——先看承受能力,再看具体原因。
三、睡眠分数:不只看睡了几个小时
睡眠分数(Sleep Score)分析睡眠阶段、时长和中断次数,官方还配了一个智能闹钟,在「最佳时刻」唤醒。截图里是 41 分,和「只睡了 5 小时、深度睡眠偏低」的描述对应。
「最佳时刻唤醒」这件事的原理不复杂:在浅睡阶段唤醒,人醒来的主观感受会比在深睡阶段被叫醒好得多,这就是所谓的睡眠惯性。消费级设备靠心率和体动推断睡眠阶段,精度有限,所以这个功能更接近「在某个时间窗口内挑一个相对浅的时刻」,而不是精确的实验室级判断。设闹钟时给一个 30 分钟的窗口比较合理,窗口太窄,算法没有腾挪空间;窗口太宽,你可能会被提前半小时叫醒。
睡眠分数还有一个容易踩的坑:它会奖励「躺得久」。如果你周末在床上赖到中午,分数可能很好看,但那不叫睡得好,叫睡得多。看这个数字时最好同时看一眼「睡眠效率」——在床上的时间里真正睡着的比例。
四、压力分数:把「感觉紧张」变成一个数值
压力分数(Stress Score)实时显示压力水平。首页的「压力与能量」区块里,当前压力是 24,标注为「低」。这个数值通常由心率变异度和心率共同推算,逻辑是:交感神经兴奋时心率变异性下降、心率上升,反之则说明身体处于放松状态。
实时压力最大的价值是「事后归因」。你晚上回头看一天的曲线,会发现某个会议、某杯咖啡、某段堵车对应着明显的峰值。这种反馈比任何「深呼吸放松」的提示都有用,因为它让你看见了自己身体的反应模式。
但实时数值不该被当成即时情绪标签。一次爬楼梯、一杯浓咖啡、一场紧张的会议,都会让压力分数冲高,它们的原因完全不同,App 分不出来。把它当成「身体负荷的仪表盘」而不是「心理状态的测谎仪」,用起来才不容易焦虑。
五、营养分数:记录方式的度是重点
营养分数(Nutrition Score)是这套产品里最「重」的模块。记录方式给了四种:条形码扫描、图像搜索、创建食谱、直接用文字描述一顿饭。官方称食物数据库有 600 万条以上,可以设置卡路里、宏量营养素和微量营养素目标,还支持血糖跟踪。
四种记录方式对应四种耐心程度。条形码最快,适合包装食品;图像搜索适合外卖和餐厅;创建食谱适合天天自己做同样几道菜的人;文字描述最灵活,比如「一碗牛肉面,加了个卤蛋」,但估算误差也最大。产品把最省事的方式放在前面,是懂用户的——饮食记录这类功能,七成的人死在「记了三顿就嫌烦」。
需要说清楚的是,营养分数的意义在于「结构性反馈」,不在于精确到克。你今天蛋白质吃了 60 克还是 75 克,App 估不准;但你连续一周蛋白质都只占热量的 12%,这个信号是可信的,值得调整。
六、力量训练器:700+ 动作背后的课表逻辑
力量训练器(Strength Builder)官方给出的数字是 700 个以上锻炼选择,可以同步手表与手机、实时反馈肌肉压力、生成定制计划。这个动作库的规模在同类产品里属于中上——够用,但不算特别夸张。
它真正的价值不在动作数量,而在「实时反馈肌肉压力」。传统的力量训练记录是「做了几组几次、用了多重」,这套记录法对新手没什么指导意义,因为他不知道这一组该不该做到力竭。如果能按肌肉群的受力情况给出反馈,训练强度就有了一个客观参照。
定制计划这部分要降低预期。算法生成的计划能保证结构合理——推拉腿分开、大肌群优先、组间休息够——但它不知道你的关节旧伤、不知道你健身房那台器械被人占了、不知道你昨天搬了一天家。把生成的计划当草稿,按自己的实际情况改,比照单全收更靠谱。
七、能量银行:一个数字解释一整天
能量银行(Energy Bank)把恢复、睡眠、压力三个信号合成一个单一指标。这个设计思路很直白:人不想每天早上看三个数再做心算,给一个数最省事。
合成指标的通病是「不可解释」。当它显示「今天能量不足」时,你没法立刻判断是睡少了、压力大了还是昨天练狠了,得点进去拆。这是所有聚合型指标的共同代价——提升了易读性,牺牲了可诊断性。
它的合理用法是「看一眼,觉得不对再拆」。如果连续一周能量银行都在低位,那就值得认真翻一遍各个分项;如果只是某一天偏低,通常不需要任何行动。
八、生物学:长期指标才是真正的健康信号
生物学(Biology)模块跟踪 VO2 max、HRV 和体成分。这三个指标的共同点是变化慢——VO2 max 想提升几个点要按周甚至按月算,体成分想有明显变化要按月算,HRV 的基线漂移也要看四周以上的数据。
变化慢意味着它们不适合天天看。天天看只会看到噪声,然后得出「我是不是退步了」的错误结论。合理的使用频率是每两到四周看一次趋势线。
VO2 max 特别值得单独说一句。它是目前消费级设备能给出的、与长期健康关联最明确的指标之一,但设备估算的 VO2 max 误差不小——它通常由心率对配速的响应反推,跑跑步机、骑车、走路给出的值可能差出好几个点。看它的变化方向,不要看它的绝对值,更不要拿它和别人比。
九、日志:把「感觉」变成可对照的记录
日志(Journal)记录饮水、日照、屏幕时间这类习惯,用来看它们对睡眠与恢复的影响。这是整个产品里最容易被低估的模块。
健康数据最大的问题是相关性不等于因果。你某天恢复分数很高,可能是因为睡得好,可能是因为那天没开会,也可能只是因为前几天太累了。日志的作用是给你一个可以回头对照的变量表——连续记一个月,你才有机会发现「每次晚上喝两杯水,夜里就多醒一次」这种个人化的规律。
它要求用户主动输入,所以留存率不会高。但如果能坚持记两周,得到的信息量比看两周的恢复分数曲线更大,因为前者是你独有的,后者是算法给的。
恢复分数与应变分数到底在算什么
首页三个环里,恢复和应变是一对。理解这一对的关系,比理解任何单个数字都重要。
应变(Strain)衡量的是你这一天承受了多少负荷——训练量、日常活动、甚至长时间的精神紧张都会推高它。恢复衡量的是你还剩多少余量。截图里应变 75、恢复 40,这个组合读起来就是「今天扛了不少,但账上余额不多」。
这两个数必须一起看,四种组合对应四种完全不同的行动:
应变高、恢复低——典型的过量信号。这时候减量不是偷懒,是止损。应变高、恢复高——状态好,该练就练,别浪费。应变低、恢复高——有余量没花出去,可以加一点强度或时长。应变低、恢复低——这一组最容易被误读,很多人以为「我没练怎么还恢复低」,其实原因往往在训练之外:睡眠不足、生病前兆、持续的心理压力。
只盯恢复分数的人,会越练越保守。因为恢复低的时候不敢练,恢复高的时候又怕明天掉下来,最后还是不敢练。把应变放在旁边,你才知道「恢复低」到底是该歇,还是该换个方式练。
单日数值几乎没有意义
恢复分数的设计初衷是「简化」,但简化到只剩一个数字,就很容易被当成考试分数。实际上它每天都在波动,而波动的很大一部分来自测量噪声,不是身体状态的真实变化。
比较靠谱的看法是基线。把你过去 7 天的恢复分数平均一下,得到一个短期基线;再看 28 天的平均,得到一个长期基线。今天的分值只有明显偏离短期基线时,才值得当成信号。落在基线上下几个点的波动,忽略即可。
这也是为什么「和别人比恢复分数」毫无意义。每个人的基线不一样,一个常年 55 分的人可能比一个常年 80 分的人状态更好,因为前者的 55 是在高强度训练周期里的 55。这个数字只对自己有效,而且只在纵向比较时有效。
它到底用了哪些输入
官方没有公开恢复分数的具体权重,能确认的是它依赖心率、心率变异度、睡眠、呼吸频率、体温这类可穿戴设备能采到的信号,以及你的训练记录。这类模型在业界有共通的做法:用个人历史数据训练一个基线,再看当天相对基线的偏离程度。
权重不公开是行业惯例,不必苛责,但要清楚它带来的后果:你无法判断某一天的低分是「真的累了」还是「算法对某个异常值过敏」。遇到明显不合理的分数,处理办法很简单——看同期的睡眠和训练记录,如果都对得上,就信;如果对不上,就忽略。
睡眠分数怎么读
睡眠是这套产品的入口。恢复分数里权重最大的输入往往是睡眠,AI 点评的第一句话也基本都在说昨晚睡得怎么样。所以有必要单独把这一块拆开。
三个维度:时长、结构、连续性
时长最好理解,也最准。消费级设备判断「你睡着了没有」的准确率相当高,因为它只需要区分「静止+心率下降」和「活动」。
结构指的是深睡、浅睡、REM 的比例。这一块是误差最大的部分。设备没有电极,只能靠心率、体动、呼吸频率去推断,而这三个信号和睡眠分期的对应关系是统计性的,不是物理性的。
连续性指的是夜里醒了几次、醒了多久。这个指标被严重低估——很多人睡够 8 小时仍然疲惫,原因是中途醒了五六次,只是自己没记住。如果你的睡眠分数长期偏低但时长足够,优先怀疑连续性。
智能闹钟的实际体验边界
智能闹钟在设定时间前的一段窗口内,挑一个体动较多、心率上升的时刻把你叫醒。它的效果取决于窗口设置:30 分钟窗口是比较实用的折中,既能给算法腾挪空间,又不至于让你在重要会议前被提前太久叫起来。
有一个细节需要提醒:这个功能要求手机或手表在睡眠期间持续采集数据,耗电会比平时高。如果你习惯不充电就睡觉,第二天早上可能要先面对低电量提醒。
和医院的多导睡眠图差在哪
多导睡眠图(PSG)要在身上贴十几个电极,测脑电、眼电、肌电、心电、血氧、呼吸气流。它是睡眠分期的金标准,因为它直接读大脑的电活动——深睡、浅睡、REM 在脑电上有明确的波形特征。
消费级设备没有脑电。它靠的是「心率在深睡时最低、REM 时波动最大、清醒时体动最多」这类间接规律。学界对这类算法的普遍结论是:总睡眠时长估得比较准,睡眠效率估得中等,深睡和 REM 的具体分钟数误差较大。所以「我昨晚深睡只有 40 分钟」这句话,应该理解成「我昨晚深睡可能偏少」,而不是一个精确到分钟的诊断。
什么时候该去做真正的睡眠监测?如果你连续几个月睡够时间仍然白天嗜睡、如果伴侣说你打鼾中间有停顿、如果你半夜频繁憋醒——这些情况去看睡眠门诊,别指望 App 给答案。这类症状对应的是睡眠呼吸暂停等问题,需要专业设备确诊。
这些指标该信到什么程度
上一节说了睡眠,这一节把范围放大到所有指标。核心结论只有一句:腕上设备给出的数字,适合看趋势,不适合当结论。原因可以拆成三层。
第一层:腕式光学心率在间歇训练时会滞后
手表背面的绿光传感器用的是光电容积脉搏波(PPG)原理——血液对光的吸收随心跳变化,传感器读这个变化来推算心率。它的优点是方便、连续,缺点是反应慢。
在稳态里,比如匀速慢跑半小时,PPG 的读数相当可靠。但在间歇训练里,心率在几十秒内从 130 冲到 175 又掉回 140,PPG 的光学信号要经过滤波和平滑,跟不上这种变化。常见的现象是:你冲到顶了,表上还显示 160;你已经开始恢复了,表上还在 170。
这直接决定了心率区间课怎么上。如果你的课表写「节奏跑 6 分钟,心率 165-175」,而你的表在间歇里滞后 20 秒,那么你在前两分钟可能一直处于「表说没到、实际已超」的状态。解决办法是用胸带(心电原理,几乎没有滞后),或者干脆按配速和体感跑,把心率当成事后校验。
一句话:稳态看心率,间歇看配速,两者冲突时信体感。这不是玄学,是因为在短时间高强度下,光学传感器的物理限制绕不过去。
第二层:HRV 对测量条件极其敏感
心率变异度(HRV)衡量的是相邻心跳之间间隔的变化程度。它不是「心率高低的波动」,而是「节拍器抖得厉害不厉害」。副交感神经占优时抖动大,交感神经占优时抖动小,所以 HRV 常被当成恢复状态的代理指标。
问题在于它太容易受影响。测量时的(躺着还是坐着)、测量时长(1 分钟还是 5 分钟)、呼吸频率、前一晚有没有喝酒、下午有没有喝咖啡、甚至憋尿,都会让同一个人在同一天的 HRV 读数差出 20 毫秒以上。
所以 HRV 的正确用法是「固定条件、长期跟踪」。手表的做法通常是夜间连续测量取平均,这个方案相对稳定,因为睡眠时和活动都受控。即便如此,单晚的数值仍然不值得当真,看一周的平均才有意义。
还有一件事必须说清楚:HRV 的绝对值和年龄、性别、体质关系极大,健康人的正常范围非常宽。看到自己的 HRV 比朋友低就担心,完全是误解。这个指标只有和自己比才有信息量。
第三层:数据链路本身会丢东西
Bevel 自己不生产硬件,它读的是别人家的数据。这就多了一层风险——字段映射、采样频率、缺失值处理。不同品牌对同一个概念的定义并不一致,比如「深睡」的判定阈值,不同厂商的算法给出的结果可能差出一大截。汇总到一个模型里需要做归一化,这一步做得怎么样,官方没有说明。
实际使用中可能遇到的情况是:同一晚,Garmin 说深睡 1 小时 20 分,Bevel 显示 55 分钟。这不一定是谁错了,而是两边定义不同。遇到这种情况,别纠结哪个对,选一个数据源长期用,保持一致性比追求准确更重要。
另外,跨设备同步有延迟。训练完了立刻打开 App,可能还没读到刚才那次跑步的数据。养成「隔几小时再看」的习惯,能避免很多「数据丢了」的误判。
训练计划怎么落到一周
截图里的训练计划页是整个产品最「实」的部分——它不是建议,是一张可以照着执行的课表。
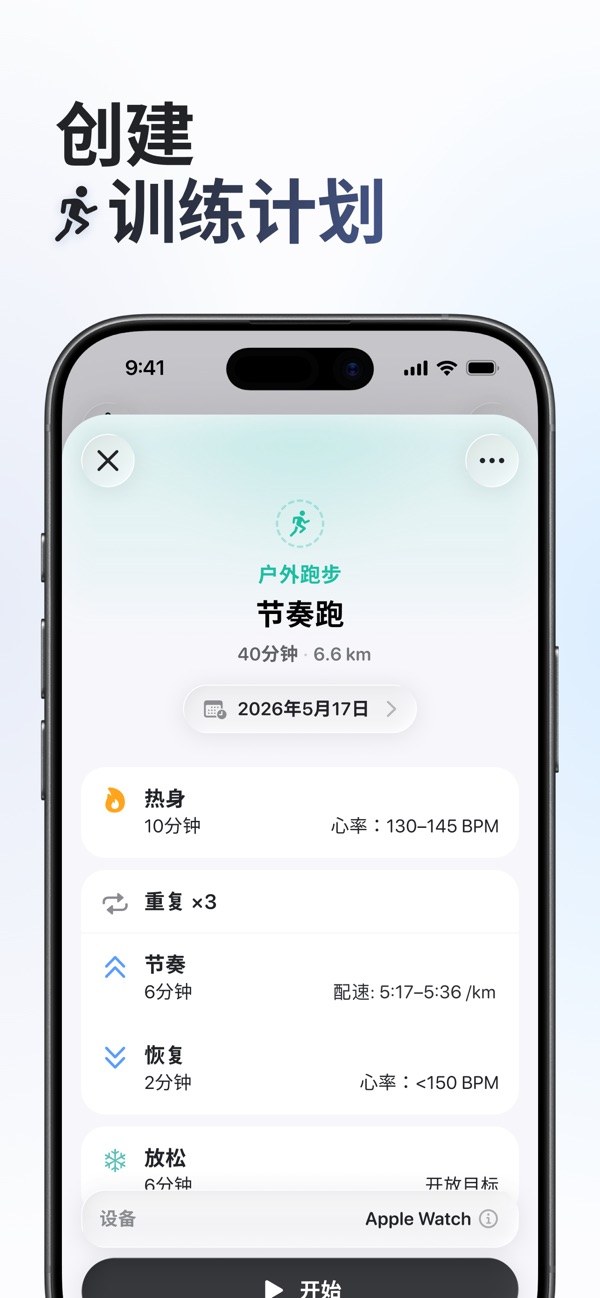
一张户外跑步的节奏跑课表:热身 10 分钟,重复 3 组(每组节奏跑 6 分钟、恢复 2 分钟),最后放松 6 分钟,页面底部是「开始」按钮。
把这张课表拆开看,信息量不小。标题是「户外跑步 · 节奏跑 · 40 分钟 · 6.6km」。热身 10 分钟标了心率区间 130-145 BPM;重复段落是「节奏 6 分钟,配速 5:17-5:36/km」,共 3 组;组间恢复 2 分钟,要求心率降到 150 BPM 以下;最后放松 6 分钟。
算一下时间:10 + 3×(6+2) + 6 = 40 分钟,和标题对得上。再算距离:按 5:17 到 5:36 的配速跑 6 分钟,每组大约 1.07 到 1.13 公里,三组约 3.2 到 3.4 公里;热身和放松按慢跑算,总共 6.6 公里是合理的。这张课表在数学上是自洽的,说明它不是随便生成的一串数字。
为什么用配速卡节奏段,用心率卡热身和恢复
这个设计挺讲究。节奏跑的目标是让身体在乳酸阈值附近工作一段时间,这个「附近」用配速控制更直接——你知道自己 5:20 的配速大概是什么感觉,跑起来就有数。而热身和恢复的目标是「不要太高也不要太低」,用心率控制更合适,因为慢跑的配速受坡度、风向影响太大。
反过来,如果热身也用配速卡,你在逆风路段会跑得心率飙高;如果节奏段也用心率卡,PPG 的滞后会让你在每组前两分钟跑得太快。混用两种控制方式,是懂训练的写法。
「心率降到 150 以下再开始下一组」这条也值得说。它把恢复做成了条件而不是时间——不是「休息 2 分钟」,而是「休息到心率降下来」。实际执行时如果 2 分钟没降下来,说明这一组跑过了,下一组要收着点。这是很实用的自我校正机制。
一周怎么排
单节课表只能解决「今天练什么」,一周的结构才决定训练效果。合理的排法是「强度日之间隔开,轻松日真的轻松」。以跑步为例,一周三到四次比较适合大多数人:一次节奏跑(就是截图这种)、一次长距离慢跑、一到两次轻松跑,中间穿插完全休息日。
Bevel 的训练计划能不能自动排出这种周结构,截图里看不出来。从产品逻辑推测,它会结合恢复分数来安排强度——恢复低的日子推轻松课,恢复高的日子推强度课。这个思路是对的,但有个隐患:如果算法过于保守,你可能一整周都在跑轻松跑,训练不够。
所以拿到计划后要人工过一遍:这周有没有至少一次真正吃力的课?如果没有,自己加一次。计划是起点,不是。
日历同步:这次更新里最实用的一条
v3.2.6 新增了日历同步,训练计划和已安排的体能训练可以写进 Google 日历或 Apple 日历,路径在「设置 > Bevel Intelligence > 日历」。
这条功能听起来不起眼,实际解决了训练计划最大的失败原因——忘记。计划做得再好,如果它只躺在 App 里,你打开别的应用就看不见了。写进日历之后,它会和你所有其他安排放在一起,冲突一眼可见。
同一个版本还做了几件事:大幅提升数据加载速度、改进 Bevel Intelligence 的工具栏与动画、心肺的最快用时改为按总用时统计(含暂停)、心率区间设置可以设更低的最高心率和乳酸阈值心率、改进德语本地化、若干问题修复。其中「最快用时含暂停」这一条是修正——之前排除了暂停时间,会让绕圈或者等红绿灯的成绩偏乐观,改成总用时更符合实际。
心率区间那条需要单独解释。它允许用户把最高心率和乳酸阈值心率设得更低,官方明确说这是为服用 β 受体阻滞剂等降心率药物的人准备的。这是一条产品适配说明,不是医学建议——这类药物会压低心率,用默认的最大心率公式算出来的区间会整体偏高,练起来容易过量。是否调整、调到多少,应该听医生的,不要自己按 App 的提示改。
营养记录与血糖跟踪
饮食记录是所有健康 App 里最难做的一块,因为它要求用户在做一件和吃饭无关的事——吃饭的时候掏出手机输入。所以评价这类功能,第一看记录成本,第二看反馈价值。
四种记录方式的实际成本
条形码扫描最快,扫一下两三秒,适合超市买的包装食品。图像搜索次之,拍一张照让算法识别,适合外卖和餐厅,但识别错了要手动改。创建食谱最麻烦,但一次投入长期受益——如果你每天早上都吃同样的燕麦加鸡蛋,建一次食谱之后每天一键复用。文字描述最灵活,适合中式家常菜这种「一盘菜里有五六种食材」的场景。
官方称食物数据库有 600 万条以上。这个量级在国际产品里属于主流水平,但中文食物的覆盖度是另一回事。西式食材好建库——一片全麦面包、一份鸡胸肉,份量和营养都是标准化的;中式烹饪的难点在「一盘青椒炒肉丝里到底放了多少油」。这类问题不是数据库条数能解决的,官方也没有说明中文食物库的具体覆盖情况,实际使用中需要做好手动修正的准备。
同理,力量训练器那 700 多个动作的中文命名和演示,官方也没有说明本地化的具体程度。界面是完全中文化的,支持的语言列表里有简体中文和繁体中文,这一点可以确认;但内容库的中文化深度,只能装上之后自己看。
宏量营养素目标怎么设
App 允许设置卡路里、宏量营养素和微量营养素目标。这三个的优先级不一样:卡路里决定体重方向,蛋白质决定肌肉保留,碳水和脂肪的分配影响训练感受。微量营养素最细,但优先级最低,日常饮食多样化的人基本不用管。
建议只设两个目标——卡路里和蛋白质。设太多目标的结果通常是每天都完不成,然后放弃记录。健康类工具的通病是「功能越多,坚持越难」,用到三成功能并且坚持三个月,胜过用全部功能坚持一周。
血糖跟踪的边界
产品支持血糖跟踪。这里必须说清楚:手机和手表不能测血糖,这个功能是让你手动录入或者从连续血糖监测设备(CGM)导入数据,然后和饮食、记录放在一起看。
它的价值在于关联分析——同样是吃一碗米饭,饭前走十分钟和饭后直接坐着,血糖曲线差别很大。这种反馈对理解自己的身体很有帮助。
但边界也很清楚:它不是医疗器械,不能用于糖尿病的诊断、治疗或用药决策。如果你在用 CGM,那是医生给你开的方案,App 只是把数据可视化,任何调整都要回到医生那里。把健康 App 的曲线当成用药依据,是这类产品最危险的使用方式。
支持哪些设备与数据来源
Bevel 不绑定硬件,这是它和很多 App 最大的区别。前面提过,它读取的是 Apple Watch、GARMIN、OURA、amazfit 和 Google Health 这五类来源的数据。
这句话可以再展开一层:它不做硬件,做的是硬件之上的分析层。自己造表的人受限于产能和供应链,读别人数据的人受限于接口和字段,两种路线的天花板不一样,但后者的起步门槛更低——用户不用换设备就能用。
这五类覆盖了不同的用户群。Apple Watch 是 iPhone 用户的默认选择,数据最全;GARMIN 面向严肃跑者和铁三玩家,训练数据最专业;OURA 是戒指形态,主打睡眠和恢复,戴着的舒适度比手表好;amazfit 走性价比路线,续航长;Google Health 是数据聚合层,能把多个来源的数据合并。
能同时读这几家,意味着你看到的分数是跨品牌归一化之后的产物。好处是换设备不用换 App,历史数据也能勉强接上;风险是数据质量参差不齐——同一套模型,底层换了一个传感器,输出的可信度就不一样。
数据从哪来,决定了分数有多可信
同样是恢复分数,用 Apple Watch 的数据算和用 OURA 戒指的数据算,结果可能不一样。戒指贴在手指上,末梢血流信号更稳定,夜间测量的连续性也更好;手表的贴合度受表带松紧影响,夜里翻身可能导致信号丢失。
所以换设备之后,你的基线需要重新建立。不要拿新设备第一周的分数和旧设备的历史数据直接比,那是在比两个不同的仪器。换设备后给自己两周时间重新找基线,是比较稳妥的做法。
系统要求与兼容性
最低系统版本是 iOS 18.0,这个门槛不低——它意味着 iPhone XS 及更早的机型、以及一些没有升级系统的设备都用不了。安装前先确认自己的系统版本,省得下载完发现装不上。
支持的语言有荷兰语、英语、法语、德语、意大利语、日语、波兰语、葡萄牙语、俄语、西班牙语、简体中文、繁体中文、语。十三个语种,覆盖得算广,简体中文在列,界面已经本地化,这一点可以放心。
收费模式与那个 916 MB 的安装包
Bevel 在 App Store 上是免费下载,核心功能需要订阅。具体价格官方页面未在可核验范围内公开,本文不给数字,也不建议你参考任何非官方的报价——订阅价格会随地区和促销变动,唯一准确的信息在 App 内的订阅页。
免费能用到什么程度
免费下载通常意味着有一个可用的免费层,但边界在哪里,官方没有在商店页面明确列出。从这类产品的普遍做法推测,基础的数据展示(步数、心率、睡眠时长)大概率免费,而恢复分数、AI 对话、训练计划这类「智能」部分大概率在订阅后面。
实际做法很简单:装上,用三天,看哪些功能弹出订阅提示。三天的试错成本远低于看十篇评测。
订阅制对健康 App 意味着什么
健康类订阅有个结构性问题:付费发生在「你想变健康」的那一刻,价值兑现发生在「三个月后」。中间这段时间,用户很容易忘记自己付过钱。
Bevel 对抗这个问题的方式是每日推送——每天早上一句建议,把你拉回来一次。这个设计是有效的,但也是的:如果你的生活节奏不允许每天早上看手机,订阅的价值就会打折。
判断要不要订阅,别看功能列表,看你能不能坚持每天早上打开它一次。能,订阅划算;不能,免费层够用。
916 MB 是什么概念
916 MB 在同类型应用里属于偏重的一档。常见的健康类 App 大多在 100 到 300 MB 之间,超过 800 MB 的通常是两种情况:内置了大量视频或动画素材,或者打包了本地模型。
Bevel 大概率两者都有。700 多个训练动作如果每个都有演示动画,光是素材就能占几百兆;600 万条食物数据库如果带图片,也是一笔不小的体积。这些内容放在本地的好处是打开快、不依赖网络,坏处就是占空间。
对 64 GB 机型来说,这个体积需要认真考虑。系统和预装应用通常已经吃掉 15 到 20 GB,加上微信这类应用,剩下的空间可能只有十几个 GB。装一个 916 MB 的 App 不算致命,但如果它还在使用中持续缓存数据(训练记录、食物图片),实际占用会继续涨。装之前先看一眼「iPhone 储存空间」,比装完再删更省事。
另外,首次下载和更新都需要不小的流量。如果你经常在没有 Wi-Fi 的环境下更新应用,建议把自动更新关掉,手动挑时间。
适用人群与不适用人群
一款产品值不值得装,取决于你是谁。这一节把话说直白一点。
适合的人
第一类,已经有手表或戒指,数据一大堆但不知道怎么用的人。这类用户最容易被说服——他们不缺数据,缺的是解释。把 Garmin 或者 OURA 的数据接进来,第二天早上就能看到一句人话,这个价值是立刻兑现的。
第二类,有明确训练目标的人。备赛、减脂、提升 VO2 max,这类目标需要结构化的课表,而不是「今天想跑就跑」。截图里那张节奏跑课表,就是这个场景的标准产物。
第三类,睡眠有问题但还没到看医生的程度的人。想找出「为什么我总在凌晨三点醒」的规律,靠日志加睡眠分数做归因,比凭感觉猜有效。
不适合的人
想找医疗级诊断的人不要装。它给的是行为建议,不是诊断结论。心率异常、血压异常、血糖异常,这些要去看医生,App 帮不上忙,还可能误导。
用 Android 的人装不了。iOS 18.0 起的门槛也把一部分老机型挡在外面。
不愿意订阅的人要掂量。免费层能给的东西有限,如果核心功能都在付费墙后面,免费版更像一个试用装。
手机存储紧张的人也要考虑。916 MB 加上后续缓存,对 64 GB 机型是不小的负担。
只想要一个简单计步器的人不必装。这类需求用系统自带的健康应用就够了,多装一个反而增加认知负担。
三个具体场景
场景一:你是个每周跑三次的业余跑者,最近想破半马 PB。把 Garmin 的数据接进来,让它排四周的课表,每周日看一眼下周安排,确认强度够不够。恢复分数低的日子,把节奏跑换成轻松跑。
场景二:你睡眠不好,白天靠咖啡撑着。戴着手表睡两周,每天记一条「今天喝了多少咖啡、几点睡的」,两周后回看,可能会发现一个你自己都没注意到的规律。
场景三:你刚开始健身,不知道怎么安排。用力量训练器生成一个计划,但每周只照着做七成,剩下三成按当天状态调整。新手期最重要的不是计划多完美,是别受伤。
常见问题
Bevel 必须订阅才能用吗?
免费下载,核心功能需要订阅。具体哪些功能免费、哪些在付费墙后面,官方没有在商店页面逐条列出。订阅价格同样未公开,以 App 内实际显示为准。
支持中文吗?
支持简体中文和繁体中文,界面已经完全本地化。但训练动作库和食物数据库的中文内容覆盖到什么程度,官方没有说明,需要在应用内实际确认。
能和 Garmin、Oura 这些设备连吗?
可以。官方列出的兼容设备包括 Apple Watch、GARMIN、OURA、amazfit,以及 Google Health。连接方式通常是通过各家开放的健康数据接口授权读取。
它测出来的数据准不准?
取决于数据来源和指标类型。总睡眠时长、静息心率这类相对简单,误差小;深睡比例、HRV、VO2 max 这类需要间接推算的,误差较大。总体原则是看趋势不看绝对值,看自己不和别人比。
它能代替医生吗?
不能。它提供的是行为层面的参考建议,不具备任何诊断能力。涉及心率异常、血糖、用药调整的问题,必须由医生判断。这一点在涉及 β 受体阻滞剂等降心率药物时尤其重要——App 提供的心率区间设置只是产品功能,不是医学指导。
换手机或者换手表,数据会丢吗?
账号数据通常跟着账号走,但基线需要重建。换设备之后的前两周,各项分数会有一段「重新学习」的时期,这段时间的数值不宜和历史数据直接比较。
为什么安装包这么大?
约 916 MB,主要来自本地的训练动作素材和食物数据库。体积大换来的是打开快、不依赖网络,代价是占存储空间。64 GB 机型建议先确认剩余空间。
Bevel 最新版下载地址:
| 描述 | 提取码 | 下载 |
|---|---|---|
| 苹果App Store下载iOS版 | 无 | 官方下载1 |
写在最后
把 Bevel 放在整个 AI 健康应用里看,它的位置很清楚:不做硬件,不做记录,专做解释和编排。这个定位有它的道理——数据已经过剩了,缺的是把数据变成行动的那一层。
它的优点是可验证的:九项功能覆盖了从睡眠到营养的完整链路,训练课表算得通,跨品牌读取设备数据这件事本身有门槛,中文化做完了,评分样本在美国区足够大。它的不确定性也是明确的:订阅价格不公开、算法权重不公开、中文内容库的深度未知、916 MB 的体积对部分机型不友好。
其他值得一并看看的同类产品,可以顺手对比一下:主打健康数据整合的 AQ健康管家、走轻量路线的 咔皮健康、偏睡眠方向的 Remy AI 和 小睡眠,以及用摄像头做生理指标估算的 Attune Health。想先补一补健康知识再看数据,北大健康 这类科普应用更合适;如果只是想找个好看的健康追踪界面,Halo 的完成度也不错。
最后给一个判断标准:如果你已经有一块表,但每天早上只是看一眼步数就退出,那 Bevel 值得试;如果你连表都没戴习惯,先解决戴表这件事,再谈 AI 教练。工具再好,也救不了一个不产生数据的人。
相关软件
全面、高效的AI工具产品情报,发现和使用最酷的AI工具!
Ctrl + D 或 ⌘ + D 收藏本站到浏览器书签栏。