

Warning: Invalid argument supplied for foreach() in /www/wwwroot/openi.cn/wp-content/themes/onenav/inc/functions/io-single-app.php on line 367
Warning: Invalid argument supplied for foreach() in /www/wwwroot/openi.cn/wp-content/themes/onenav/inc/functions/io-single-app.php on line 367
Warning: Illegal string offset 'app_version' in /www/wwwroot/openi.cn/wp-content/themes/onenav/inc/functions/io-single-app.php on line 158
Warning: Illegal string offset 'app_status' in /www/wwwroot/openi.cn/wp-content/themes/onenav/inc/functions/io-single-app.php on line 165
Warning: Illegal string offset 'app_ad' in /www/wwwroot/openi.cn/wp-content/themes/onenav/inc/functions/io-single-app.php on line 166
Warning: Illegal string offset 'app_date' in /www/wwwroot/openi.cn/wp-content/themes/onenav/inc/functions/io-single-app.php on line 172
Warning: Illegal string offset 'app_language' in /www/wwwroot/openi.cn/wp-content/themes/onenav/inc/functions/io-single-app.php on line 174
Warning: Illegal string offset 'index' in /www/wwwroot/openi.cn/wp-content/themes/onenav/inc/functions/io-single-app.php on line 282
Donna AI Song & Music Maker 是一款 iOS 端的 AI 音乐生成应用。它在 App Store 里的定位相当清楚:把「描述—生成—试听—二次加工」这条链路压进一块手机屏幕,让没有乐理基础的人也能在几分钟内拿到一首带人声、带歌词、带编曲的完整歌曲。商店把它同时归入「音乐」与「效率」两个分类,这个选择本身就说明了产品意图——它不打算做专业 DAW 的移动版,而是把「做歌」当成一件可以被流程化、被加速的日常任务。
开发者署名是 MOBIVERSITE YAZILIM BILISIM REKLAM VE DANISMANLIK HIZMETLERI SANAYI TICARET LIMITED STI。从这个注册名的结构看(YAZILIM 对应软件、BILISIM 对应信息技术、REKLAM 对应广告、DANISMANLIK 对应咨询、TICARET 对应贸易、LIMITED SIRKETI 对应有限责任公司),商店署名主体是一家土耳其实体,主体信息以商店页为准。应用 bundle id 为 com.ai.sound.donna,当前版本 1.0.100,首次上线 2024 年 4 月 8 日,最近一次更新是 2026 年 10 月 10 日。
这篇评测要回答四件事:官方在商店描述里承诺的四项能力,落到界面上究竟是什么操作路径、边界又在哪里;它在曲风混合与人声质感这两个关键处的真实水准;AI 生成音乐的版权与商用问题该怎么看;以及一个最容易被忽略、但对中文用户最要命的问题——它在中国区可以下载,却没有中文界面。文中涉及的界面细节,来自官方宣传图与商店页公开信息;没有实测依据的部分,我会明确标成推断,而不是当成结论。
一、先把它放回坐标里:一个 198.5 MB 的移动端生成器
商店页上几个不能含糊的硬指标
先把可核验的信息摆齐。应用全名 Donna AI Song & Music Maker,免费下载、含 App 内购买,安装包 198.5 MB,最低系统要求 iOS 15.0。界面语言列出九种:语、英语、法语、德语、日语、韩语、葡萄牙语、俄语、西班牙语——没有中文。商店分类是「音乐」和「效率」,中国区可以正常搜索并下载。
这几项里,198.5 MB 这个数字值得多看一眼。同类的纯云端生成工具,安装包常常只有几十兆,因为模型和素材都在服务器上;接近 200 兆的体积通常意味着两件事之一:要么 App 里打包了较重的本地资源(音色采样、播放引擎、效果器、示例曲库、封面素材),要么内置了较完整的前端渲染与缓存模块。无论哪一种,对存储吃紧的机型都是一笔实际成本。
版本号停在 1.0.100,说明的不只是「还年轻」
从 2024 年 4 月 8 日首次上线,到 2026 年 10 月 10 日最近一次更新,中间隔了大约两年半,版本号却仍然停在 1.0.100。这个组合有两种解读:一种是产品一直以小步快跑的方式叠加功能,没有经历过架构级重写;另一种是版本号策略偏保守,用第三位数字承载所有迭代。从功能结构看,前一种解释更可能成立——它最初大概率就是一个「描述成歌」的单点工具,后来才陆续补上换声、写词、分轨、扩展这些旁支能力。
从首屏宣发看它怎么组织功能
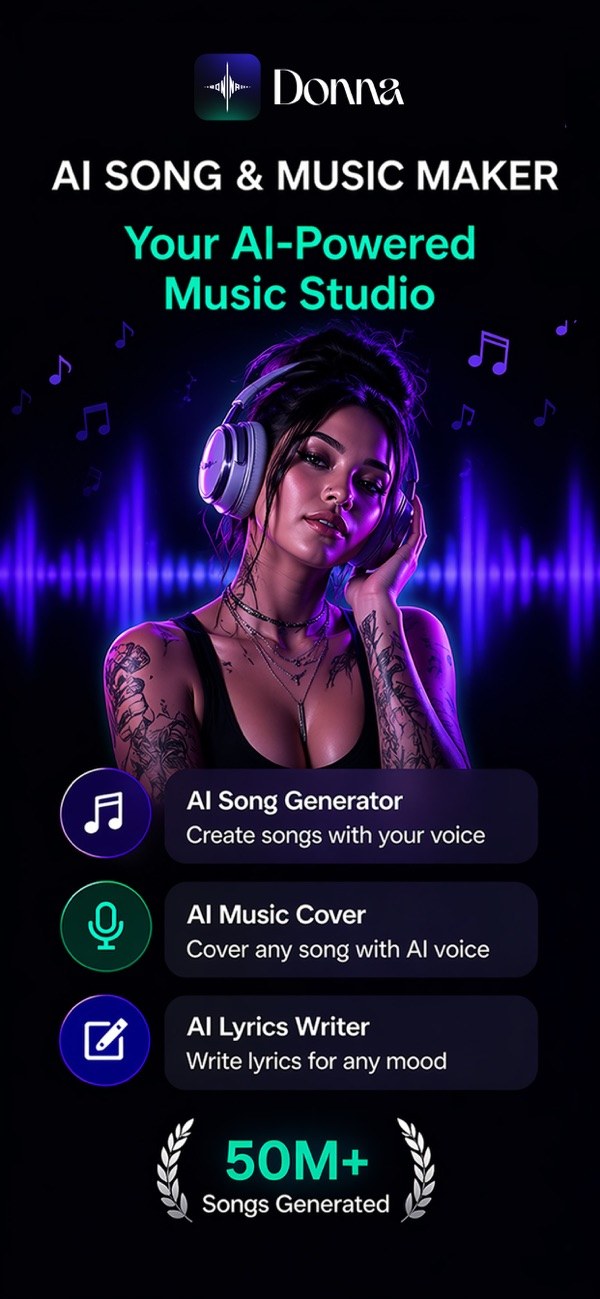 图注:官方把三件事并列放在首屏,说明它按「任务」而非按「曲风」组织功能入口。
这张宣传图的信息密度不低。画面上方是应用名与一句「Your AI-Powered Music Studio」的定位语,中间是一个戴耳机的人物与声波图形,下方三栏分别对应「AI Song Generator — Create songs with your voice」「AI Music Cover — Cover any song with AI voice」「AI Lyrics Writer — Write lyrics for any mood」,最底部标着「50M+ Songs Generated」。三个入口分别对应生成、换声、写词,这是一条很典型的「任务导向」信息架构:用户不需要先懂音乐,只需要先判断自己想做哪件事。
那个「50M+ Songs Generated」的数字出现在官方宣传物料上,属于厂商自述口径,本文不对它做验证。它至少说明一件事:这个产品把自己定位成高频消耗品,而不是低频的专业工具——五十万首和五千万首对单个用户没有区别,但对产品设计有区别,高频意味着它必须把「再来一次」的成本压到极低。
二、即时成歌:一句 vibe 到一首成品,中间隔着什么
三层输入:描述、情绪、曲风
官方描述里的第一条能力是「即时成歌」:用户描述想要的气氛(vibe),由 AI 完成从作曲到制作的全过程,相当于把一间音乐工作室装进口袋。这句话在营销上很顺,但落到界面上,它其实被拆成了三层可操作的输入。
第一层是文本。宣传图里的主界面顶部有三个标签:Song Description、Lyrics、Image To Song,默认停在第一个。中间是一个写着「Describe the Song」的输入框,框内已经填了一句示例:「A graduation anthem celebrating my sister’s first college degree, full of hope and pride.」——一句毕业颂歌,为妹妹拿到第一个大学学位而写,充满希望与自豪。这个例子很能说明它的目标用户:不是职业编曲人,而是「有一个具体场合、想说点什么、但不会写歌」的普通人。输入框右上角还有一个「Get Inspired」按钮,点下去应该是给出一段现成的描述范例,用来解决「我连怎么描述都不知道」的冷启动问题。
第二层是情绪。输入框下方是「Select Mood (Optional)」,标注了可选,横向排列着若干情绪标签,能看清的有 Happy、Confident、Motivational,右边缘还有一个被截断的标签。第三层是曲风,「Select Genre (Optional)」下面是一排带插画的方形卡片,可见的有 Random Genre、Blues、Funk、Rap、Pop,右侧仍有更多卡片延伸出屏幕。再往下是一个折叠的「Advanced Options」,以及最底部那颗蓝紫色的主按钮「Create with Description」。
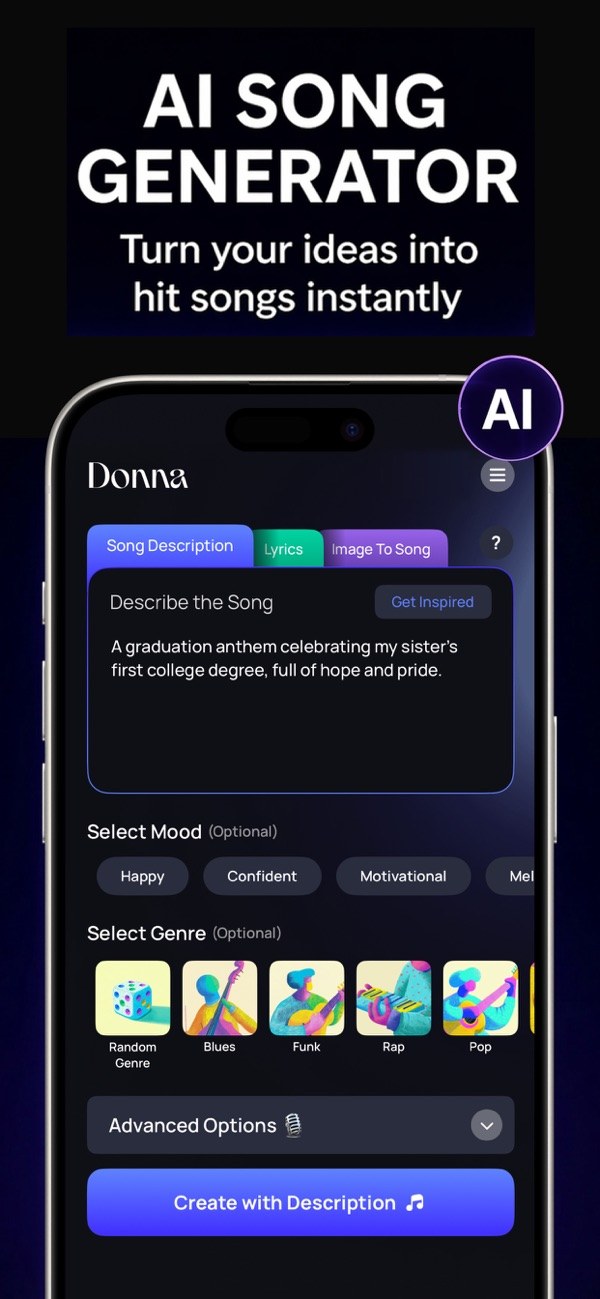 图注:输入区把「描述」拆成文本、情绪、曲风三层,这是它把表达转成可控参数的办法。
这条路径为什么比纯文本框好用
把「描述」拆成三层,是一个很务实的设计决定。纯文本输入的方差极大:同一句话,模型可能理解成抒情慢歌,也可能理解成电子舞曲;用户不知道该怎么写提示词,只能一遍遍试。加上情绪和曲风两个结构化选项后,等于给模型加了两个强约束,把结果收窄到一个可预期的区间。这对新手尤其重要——它把「提示词工程」这件需要学习的事,变成了点选。
边界:快,不等于可控
需要说清楚的是,「即时」的代价是可控性。从这个界面上,我看不到任何关于调性、BPM、拍号、段落结构(主歌几句、副歌几次、有没有桥段)、乐器编制的直接控制项。所有这些都被折叠进「Advanced Options」或者干脆交给模型判断。这意味着你能得到一首听起来完整的歌,但很难得到一首「按你的设计图纸施工」的歌。
对普通用户,这不算缺点,甚至算优点——他本来就画不出图纸。但对想拿它做商用素材的人,这是硬约束:一条 15 秒的广告片需要卡在固定节拍上,一个播客片头需要精确的 8 秒收尾,这类需求靠「描述 + 重roll」的效率极低。宣传图里播放器显示已播 3:58、剩余 0:36,成品在四分钟出头这个量级,也印证了它的默认产出是「一首完整的歌」,而不是「一段可拼接的素材」。
三、曲风与跨曲风混合:Rap 的高能量加流行人声意味着什么
官方举的那个例子,重点在配比
官方四项能力里的第二条是「广曲风 + 跨曲风混合」,举的例子是把说唱的高能量与流行乐的人声旋律结合,打破传统曲风边界。这个例子选得很准,因为它描述的正是过去十年流行音乐工业里最主流的一种做法:说唱的节奏密度负责推进感,流行人声的旋律负责记忆点。它不是「把两个标签贴在一起」,而是一种有明确分工的编曲策略。
所以判断这类功能好不好用,不该看它支持多少个曲风标签,而该看它能不能理解「配比」。同样叫「Rap + Pop」,主歌全说唱副歌全唱,和主歌半说半唱、副歌加和声,是两首完全不同的歌。如果产品只能做前一种,那它给的其实是「一个预设模板」;如果它能通过描述里的措辞(比如「主歌说唱、副歌旋律化」)来调整段落分工,那才叫真正的混合。
从可见的界面看,曲风是以卡片形式单选或多选的,标签本身是粗粒度的(Blues、Funk、Rap、Pop 这一级)。粗粒度标签的好处是门槛低,坏处是无法表达子类型——Trap 和 Boom Bap 都归在 Rap 里,City Pop 和 Synth Pop 都归在 Pop 里,而这两组子类型的听感差异,比 Rap 和 Pop 之间的差异还大。想做出细分风格,只能靠描述文本补充,这就又回到提示词能力上了。
风格混合的真实门槛在「一致性」
跨曲风混合最难的地方,从来不是开头,而是维持。一段 30 秒的融合很容易惊艳,四分钟的融合很容易散架:鼓组换了、贝斯线的音色没跟上、副歌突然变成了另一种制作审美。这类问题在生成式音乐里非常普遍,因为模型是逐段预测的,它没有「整首歌的统一制作语言」这种全局意识。
这也是为什么「歌曲扩展」这个功能在技术上比听起来难得多——它要求模型在续写时保持前面的调性、速度、音色和混音风格,任何一项漂移,接缝就会露出来。官方把它列进功能清单,说明产品认为自己能处理这个问题;但这类能力的实际表现,只有在多次生成后才能判断,本文不做无依据的断言。
如果你本来就打算做说唱,站内还有一篇专门整理 AI 说唱工具的文章,AI 音乐生成工具如何创建个性化说唱歌曲与歌词,里面把「flow 密度」「押韵方案」这些更细的维度拆得比较清楚,配合 Donna 的曲风标签一起看,会更容易理解粗粒度标签丢失了什么。而如果你更在意多模态输入(比如用一段参考音频定风格),MELO音乐这个多模态 AI 音乐生成平台是另一种思路,它的输入侧比纯文字宽。
四、人声与乐器:「听起来像真录」到底差在哪
三个可听的维度:咬字、气息、动态
官方第三条能力是「真实感人声与乐器」:生成含歌词、以仿真人声演唱、乐器听起来像真实录音。这句话里的「逼真」是个很滑的词,需要拆开看。判断一段 AI 人声像不像真人,我通常看三件事。
第一是咬字。真人在唱不同元音时,口腔形状会变,辅音会有轻重;AI 人声常见的毛病是「每个字都太清楚」,反而显得机械,或者在连读、吞音这些真实演唱里大量存在的地方露馅。第二是气息。换气点在哪里、气声的比例、长音末尾的自然衰减,这些细节决定了人声有没有「身体感」。第三是动态——真唱一句歌,音量不是恒定的,情绪推进时会有细微的强弱变化,而 AI 往往把整段压得很平。
就英文而言,宣传图里那段以「When the world is fast asleep」开头的歌词,四行一节,sleep/deep、sky/haze 押得规整,是很典型的英文流行歌词模板。这类词交给模型去唱,成功率最高,因为训练样本最多。
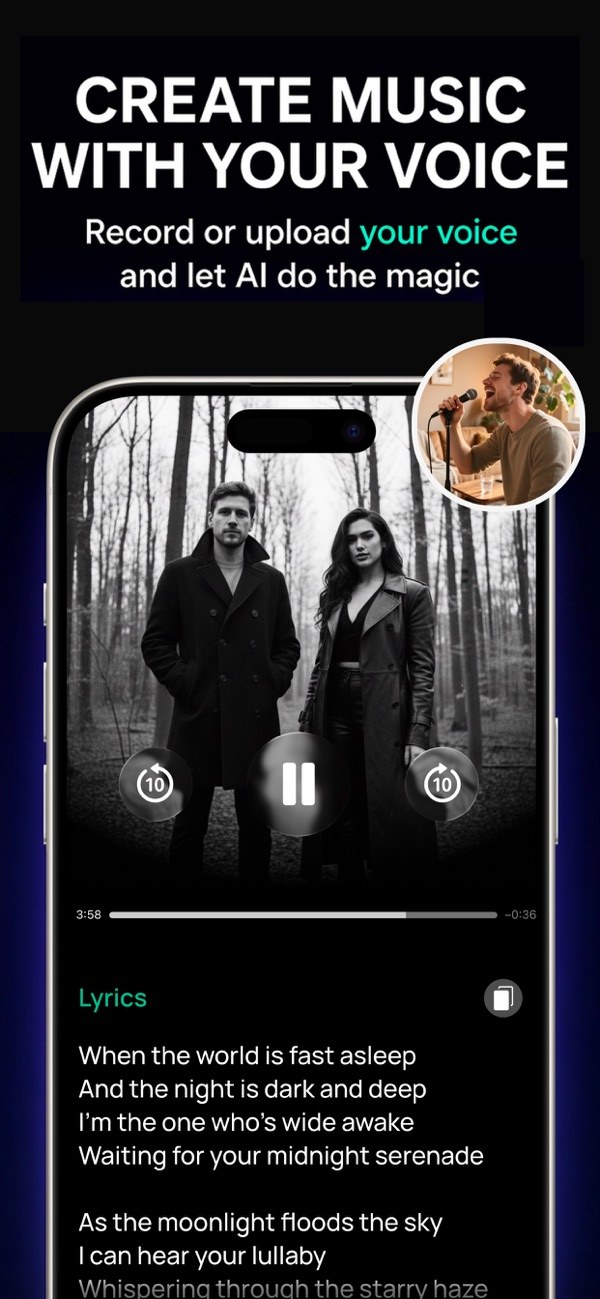 图注:成品页把封面、播放控制与滚动歌词放在同一屏,说明它想让你在这里听完,而不是导出到别处听。
播放器这一屏透露的产品观
这张图展示的是成品播放页:上半屏是生成的黑白树林双人封面,是暂停键,左右各一个「10 秒」快退快进按钮;下半屏是「Lyrics」标题、右上角的复制图标,以及逐行排列的歌词。整个布局的重心明显偏「消费」而不是「制作」——它希望你在这里把歌听完,甚至把歌词复制走发出去。
那个复制按钮是个很实用的细节。AI 生成的歌词往往是整首歌里最有复用价值的部分:可以拿去改、拿去发社交平台、拿去给别的人声模型重唱。一个按钮省掉了长按选择的麻烦,这种小设计比多一个花哨功能更能说明团队在想什么。
但也正因为重心偏消费,它对「后期」的支持是薄弱的。界面上看不到均衡、压缩、混响这类基础处理,也看不到多轨时间轴。想把人声和伴奏的比例调一调,只能靠重新生成碰运气。这是移动端产品的通病,不算它独有的缺点,但在评测里必须点明:它给你的是一首「可以听的歌」,不是一份「可以混的工程」。
乐器质感:短板通常藏在瞬态和高频
乐器这一侧,「像真录」的难点和绘画里的手一样——都在细节的物理性上。钢琴的真实感来自琴槌击弦的瞬态和踏板共鸣,鼓的真实感来自每一下击打的力度差异和房间反射,吉他的真实感来自手指摩擦琴弦的噪声。AI 生成的乐器往往在这三处偏「干净」:太干净就假。
另一个常被忽略的问题是混音。一首歌听起来是否专业,很大程度取决于人声和伴奏在频段上有没有互相让位。生成模型通常会把所有元素堆在同样的中频,结果是人声一进来,伴奏就糊了。这类问题在手机上用外放听不太出来,戴上耳机就很明显。
所以对「逼真」这个宣传点,我的判断是:在人声这一侧,它达到的水平足以让普通听众在短视频场景下不觉得违和;在乐器独奏、爵士三重奏、古典编制这类要求「每件乐器都有空间」的场景,它大概率还不够。这不是贬低,而是这类产品的合理边界——它的目标是「像一首歌」,不是「像一次录音」。
五、灵感引擎:它给的是起点,不是答案
「意想不到」比「省时间」更值钱
官方第四条能力叫「灵感引擎」:不只节省时间,还提供意想不到的起点,用户可以在产出基础上继续精修。这条描述里最有价值的是后半句——它承认了自己的产物是「半成品」,需要人接手。很多同类产品在宣传时会暗示「一键出成品」,反而把用户的预期抬到了不可能兑现的高度。
「意想不到」这件事在技术上其实有朴素解释:生成模型是在训练数据的高维空间里采样,它能组合出人类制作人因为习惯而不会去尝试的搭配——一段手风琴配 808 鼓,一段合唱铺在失真吉他上。这些组合大部分是噪音,但偶尔会有一个让你停下来。灵感引擎的价值不在于它「懂你」,而在于它「不按你的习惯出牌」。
这也解释了为什么「Random Genre」这个选项应该被认真对待。它不是为了偷懒,而是为了制造偏差。当你连续生成五版都差不多的时候,随机一次,往往比继续微调描述更有用。
把生成结果当素材,而不是当答案
基于这个定位,我建议的工作流是这样的:先用两三句描述生成四到六个版本,不要指望第一版就能用;听的时候不要整体判断「好不好听」,而是找「哪 8 秒有意思」;找到之后用扩展功能把那一段变长,或者用分轨把里面的人声或某个乐器单独拿出来;最后拿去做二次加工。这套流程把 AI 放在「素材供应商」的位置上,产出质量会比「一次生成直接发布」高一个档次。
国内的创作者其实对这套流程不陌生。抖音音乐创作实验室这类工具走的也是「先给你一个可用的片段,再让你在剪辑里成型」的路子,差别只在于它更贴近短视频的时长与节奏需求。如果你的产出目的就是发短视频,这类工具在「卡点」和「时长适配」上会比通用生成器更顺手。
需要提醒的是,「在产出基础上继续精修」这句话在 Donna 里能落到什么程度,取决于它开放了多少编辑能力。从可见界面看,它能做的是扩展时长、分离轨道、换声、复制歌词——这些都是「片段级」操作,还不到「音符级」。想改一个音、挪一个拍子,它做不到。这是移动端 AI 音乐工具的普遍天花板,短期内也很难突破,因为精细编辑需要时间轴和波形界面,那和「一分钟出歌」的产品哲学是冲突的。
六、把歌做长、把轨道拆开:扩展与分轨这两件事
歌曲扩展:时长是结构问题,不是长度问题
原稿提到的「歌曲扩展」,指的是可以增加歌曲时长,让创作者按自己的需求调整长度。听起来像个简单的功能,实际上它是整条链路里技术难度最高的之一。
原因在于,「变长」不等于「重复」。一首歌从 30 秒扩到 3 分钟,需要的是结构:主歌、预副歌、副歌、第二段主歌、桥段、尾声,每一段的和声走向、配器密度、情绪强度都要有变化。如果模型只是把已有段落循环拼接,听两遍就会腻;如果它续写,又容易跑调、跑拍、跑风格。真正的难点是在「不重复」和「不跑偏」之间找平衡。
对使用者来说,这里有一个实用判断标准:扩展之后,接缝处的那一两秒有没有突兀感。如果有明显的「换了一首歌」的感觉,说明它的续写没有锁住上下文;如果听起来像同一首歌自然往下走,那这个功能才算及格。这一点我建议每个使用者在正式用之前都手动验证一次,因为宣传物料不会展示失败案例。
音频分轨:从成品回到素材
「音频分轨」是把歌曲里的人声、乐器、鼓点等元素分离成轨道,方便进一步混音和编辑。这个功能的意义,在于它把「成品」重新变回「素材」——你可以只留伴奏,自己唱;可以只留鼓,配别的旋律;可以把人声降下来当背景。
分轨的质量高度依赖原曲的混音密度。人声居中、伴奏稀疏的曲子,分离出来通常比较干净;而失真吉他铺满、鼓和贝斯挤在低频的曲子,分离后人声里会带明显的「水声」残留,鼓轨里会混进贝斯的尾巴。这是这类算法的物理限制,不是产品缺陷,但用户需要知道预期。
从产品设计看,把分轨放进移动端是个聪明的选择。它让「AI 生成」和「人工再创作」之间有了接口:不会写歌的人用生成,会一点制作的人用分轨。这个接口的存在,让 Donna 的用户画像比「纯小白工具」宽了一档。
两个容易被忽略的旁支:换声与写词
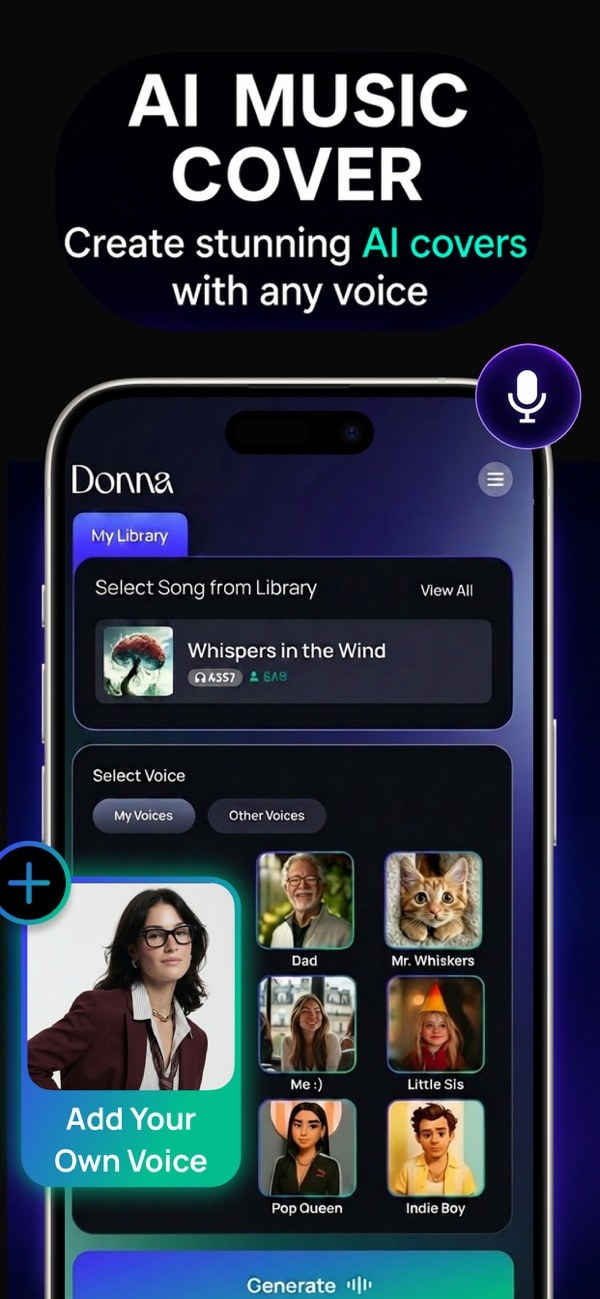 图注:换声必须先选库内曲目,这条入口和「从零生成」是两条完全不同的路。
「AI Music Cover」的流程在这张图里展示得很完整:先「Select Song from Library」(曲库中选中了 Whispers in the Wind),再「Select Voice」,声线分「My Voices」和「Other Voices」两组,卡片上有 Dad、Mr Whiskers、Me :)、Little Sis、Pop Queen、Indie Boy 这些名字,左下角浮着一个「Add Your Own Voice」,底部是「Generate」按钮。
这里有个必须说清的边界:宣传语写的是「Cover any song with AI voice」,但界面显示的第一步是「从曲库选择歌曲」。也就是说,实际操作路径是「选库里已有的歌」,而不是「上传任意外部歌曲」。这不代表它一定不能处理外部音频(有些产品把上传入口藏在别处),但仅凭可见界面,不能断言它能翻唱任意歌曲。写评测时把宣传语当能力清单照抄,是最容易出错的地方。
声线命名的方式也值得一说。Dad、Little Sis、Pop Queen、Indie Boy 这类名字,加上一只叫 Mr Whiskers 的猫,明显是把「音色」包装成「角色」。这是一种降低理解成本的做法——用户不需要懂什么叫「中低频厚实的男中音」,只需要知道「这个听起来像我爸」。代价是精度:角色化的命名无法表达细微的音色差异,真正想做精细选型的人会觉得不够用。
「AI Lyrics Writer」则是按情绪写词。界面上「Write lyrics for any mood」这句定位很直白,配合主界面的 Select Mood,说明写词和生成是共用同一套情绪标签的。这条链路对「有曲子没词」的人是刚需,对「有词没曲子」的人则相反——后者应该走 Lyrics 标签页,把现成的词贴进去。两种顺序都支持,这是它比单入口产品灵活的地方。
七、版权与商用:这一节最不能含糊
为什么没有统一答案
AI 生成音乐的著作权归属,目前在各地法律下的处理并不一致。有的司法辖区要求作品必须由自然人创作才能受著作权保护,纯粹由机器生成的内容可能落入公有领域;有的地方则把「人的实质性智力投入」作为判断标准,投入多少、投入在哪一环,都会影响结论。平台条款又是另一层:即使用户协议把生成内容的商业使用权授予用户,这个授权也只约束平台与用户之间,不能对抗第三方的权利主张。
所以任何「用 Donna 做的歌一定能商用」的说法都不成立。本文也不给这个结论。能做的是把风险点列清楚,让你自己判断。
商用前的三道自检
第一道是条款。你要确认的是:平台是否明确授予商业使用权、是否要求署名、是否限制使用场景(比如禁止用于音像发行、禁止用于或内容)、以及这个授权是否可转让给你的客户。这些条款通常在应用内或官网的 Terms 里,而且会随版本更新变化,用之前应该看你使用当次的版本。商店页没有公开这些细节,只能进应用内确认。
第二道是「风格模仿」的风险。如果你的描述里写了某位在世艺人的名字,或者刻意模仿某首具体歌曲的编曲,即便旋律不构成实质相似,也可能踩到姓名权、不正当竞争或者平台的内容政策。这条风险在商用场景(广告、品牌片)里比个人发布高得多,因为投放方通常会有法务审核。
第三道是发行渠道的规则。流媒体平台、短视频平台、广告投放系统对 AI 生成内容的披露要求各不相同,有的要求标注,有的要求提供授权证明,有的直接在审核环节拦截。这些规则在变,而且各平台不统一,需要按你实际要投放的渠道逐条确认。
行业争议为什么值得作为背景
把视线拉远一点,AI 音乐这几年的争议核心其实不在「生成质量」,而在「训练数据的来源」和「对人类创作者的影响」。Suno AI CEO 关于创作过程的争议就是这类讨论的一个典型切面:当生成工具的能力强到可以批量产出「听起来像某类唱片工业产品」的东西时,原有的授权体系、分成结构、甚至「创作者」这个身份的定义,都会被动摇。
这场争议对普通用户的意义是:你用的工具处在法律与行业规则的灰色地带,而这个地带的边界正在被诉讼和立法一点点划定。今天合规的用法,明天可能因为一条判决或一次条款更新而改变。所以在商用项目里,AI 生成的部分最好保留「替代方案」——要么有真人录制的版本可以替换,要么把 AI 部分限制在非核心的位置(比如背景铺底),不要把整个项目的成败押在一段无法确权的音频上。
八、中文用户的实际门槛:没有中文界面意味着什么
第一次上手会卡在哪
这一节是我认为最需要单列的部分。Donna 在中国区可以下载,但商店描述只有英文,界面语言列表里也没有中文——九种语言覆盖了语、英语、法语、德语、日语、韩语、葡萄牙语、俄语、西班牙语,唯独缺了中文。这不是「翻译没做完」的小问题,它会在三个具体环节上造成摩擦。
第一个环节是首次启动。注册、订阅说明、权限请求(麦克风、通知、相册)、引导页,这些内容通常是英文的。对有一定英文阅读能力的人,这不构成障碍;但对「看到 Select Genre 不知道是选曲风」的用户,第一道门槛就在这里。界面上的词汇本身不算生僻(Mood、Genre、Lyrics、Generate),但连起来读仍需要一点适应。
第二个环节是描述输入。这是最要命的一处:Donna 的核心交互是「用一段话描述你想要的歌」,而这段描述的质量直接决定产出质量。用非母语写描述,你很难表达「副歌要更开阔一点,鼓可以少一点,人声靠前」这种细微的调整意图。语言能力在这里直接转化成了生成质量,这是纯界面翻译解决不了的问题。
歌词语种与咬字的偏向
第三个环节是歌词。应用能生成带歌词的歌曲,但从可见的示例看(英文四行一节、尾韵规整的抒情歌词),它的写作模板明显偏向英文流行歌的结构:短句、意象、ABAB 或 AABB 韵。中文歌词的写作逻辑完全不同——汉字单音节、有声调、讲究字数对齐和开口音闭口音的搭配,这些在英文模板里没有对应物。
如果你让它生成中文歌词,可能的结果是:词写出来了,但韵脚是按英文逻辑凑的,唱起来会有「倒字」(声调和旋律走向冲突,听不清字)。如果让它唱英文歌词,人声的仿真度会明显更高,因为训练样本更充足。这就形成了一个尴尬的选择:想要更好的音质,就得放弃母语表达;想要中文表达,就得接受成品质量下降。
这条门槛没有技术上的捷径。短期内能做的,是自己写好中文词贴进 Lyrics 标签页,把「写词」这一步从模型手里拿回来。这样至少歌词的质量可控,剩下的问题只是演唱。至于演唱环节的中文咬字,只能靠多试几版挑一个相对能听的。
客服、条款与订阅说明的语言
还有一层不容易被察觉的成本:出问题的时候。订阅扣费异常、生成失败不退额度、账号丢失,这些都需要走客服。客服支持的语言、条款的准据语言,通常跟应用的发行主体所在地绑定——一个土耳其主体、面向全球发行的应用,条款大概率以英文为准,客服也优先英文。这意味着一旦发生纠纷,你的沟通成本会显著上升。
这不是说它一定会出问题,而是说「出问题时的救济成本」是选工具时应该计入的一项。对个人娱乐用途,这个成本可以忽略;对要靠它交付项目的人,值得提前想清楚。
九、和同类放在一起看:只谈定位,不谈参数
三条不同的路线
AI 音乐生成这个赛道,现在大致分三条路线。第一条是网页端 + 订阅制,以 Suno 为代表:功能最全、可控性最强、社区生态最活跃,但它是「坐下来做音乐」的工具,需要电脑、需要时间、需要学习。第二条是对话式 Agent,比如站内介绍过的 Tunee 对话式音乐创作 Agent,用的方式逐步收敛需求,交互上更接近「跟一个制作人沟通」,适合说不清自己要什么但愿意来回讨论的人。第三条是纯文字成歌的网页工具,比如 Musci.io 输入文字生成完整歌曲,路径最短,输入一句话、输出一首歌,几乎没有中间环节。
Donna 走的是第四条:移动端 + 任务流水线。它的差异不在功能数量,而在使用场景——你在地铁上、在排队时、在突然想到一句词的时候,掏出手机就能做一个版本出来。这个场景是网页端产品结构上覆盖不了的,也是它最实在的价值。
「四步流水线」是它的产品骨架
把它的功能串起来看,其实是一条很清晰的四步流水线:第一步,用描述 / 歌词 / 图片三种入口之一生成一个初版;第二步,用扩展把有感觉的段落做长;第三步,用分轨把人声、乐器拆开,或者用换声换一个音色;第四步,导出或直接分享。这四步对应四种不同的心理状态——想、挑、改、发。
这个骨架的好处是可预期:用户第二次来的时候,知道自己在哪一步。坏处是它把创作框得太死,缺少「玩」的空间。相比之下,对话式 Agent 的松散反而更适合探索,网页端工具的度更适合精修。三种形态各有各的适用人群,不存在谁替代谁。
不做功能对比表的原因
我不打算在这里做一张「支持曲风数量 / 是否支持分轨 / 是否支持换声」的对比表。原因很简单:这类表格里的绝大多数格子,我无法用公开信息核实。商店描述是营销文案,功能清单是能力宣称,二者都不等于实际表现;不同产品的「分轨」可能指完全不同的东西(有的是 AI 分离,有的是导出多轨工程)。用未核实的信息拼一张看起来很专业的表,是对读者的误导。
更有意义的比较维度是:你要在什么设备上、花多少时间、产出什么用途的东西。设备决定形态,时间决定交互,用途决定质量下限。这三个问题答完,选哪个产品基本就清楚了。
十、边界清单:上架不等于适配
中国区已上架,但没有中文
第一件要说清的事:它在中国区 App Store 可以搜到、可以下载,这是事实;但「能下载」和「为中文用户做的」是两件事。商店描述只有英文,界面九种语言不含中文,这两点叠加起来,构不成一个面向中文市场的产品。它更像是「全球发行、恰好在中国区可售」的状态。对能读英文的用户,这不影响使用;对不能读的,第一屏就会劝退。
41 个评分能说明什么,不能说明什么
当前评分 4.39 分,共 41 个评分。这个数字必须如实说:4.39 分看起来不错,但 41 个样本在统计上几乎不构成参考。样本这么小的情况下,一个极端评价就能让分数跳动零点几分;分差在 0.3 以内基本没有意义。更重要的是,样本小往往意味着两种可能——要么应用的目标市场不在当前区(比如中国区用户少),要么它的大部分用户根本不评分。无论哪种,都不能用这个分数推断「大多数人满意」。
我通常会把「评分数」和「安装量级」放在一起看:如果官方宣称的生成量是千万级,而评分只有几十个,那说明评分池和用户池严重不匹配,这时候评分的信息量接近于零。这一点不值得粉饰。
额度与价格:官方没公开,就别猜
商店页写的是「免费下载、含 App 内购买」,但没有公开生成额度、订阅档位和具体价格。这意味着你无法在下载前判断「免费能用几次」「订阅多少钱一个月」「额度是按次还是按时长」。这些信息只能在应用内的购买页看到,而且这类产品的定价经常做 A/B 测试,不同账号看到的档位都可能不同。
所以本文不给任何价格数字。任何声称「每月 X 元」的说法,如果不是来自官方页面,都是猜测。实际使用时,建议先看清购买页的计费周期(周订阅和年订阅的差价很大)、是否自动续订、以及取消路径——这三项是最容易产生纠纷的地方。
198.5 MB 的体积意味着什么
前面提过,这个体积在同类的云端生成工具里偏大。它意味着本地有较重资源,也意味着两件具体的麻烦:一是存储紧张的手机会被挤占(尤其 64G / 128G 机型);二是首次安装和每次大版本更新的下载时间会比较长。如果你的使用频率是「一周做一首」,这个成本还算可以接受;如果只是「想试试」,接近 200 兆的下载门槛会让人犹豫。
麦克风权限:一条值得单独看的提醒
它要录音才能实现「用你的声音做歌」,这意味着它会上传你的声音样本。声音在生物识别信息里属于敏感类别,上传前值得看一眼隐私政策怎么写的——尤其是「样本是否用于模型训练」这一条。能不能接受,得自己判断。
十一、谁该装,谁可以先等等
适合的两类人
第一类是有具体场合需求、但没有音乐能力的人。生日、婚礼、毕业、日,需要一首「为某个人写的歌」,这类需求对质量的要求是「真诚、能听、有点惊喜」,而不是「专业水准」。Donna 的描述成歌路径正好对上这个场景,而且它的歌词示例(毕业颂歌)说明团队就是照着这个场景设计的。
第二类是内容创作者,需要一个快速可用的背景音或片头。短视频、播客、Vlog 对音乐的要求是「不抢戏、有情绪、长度合适」。用描述生成一版,再用扩展调到需要的时长,这条路径比在素材库里翻半天要快。前提是你能接受版权上的不确定性,或者只用在不需要严格确权的场景。
不适合的两类人
第一类是需要精确控制的人。要卡 BPM、要对画面、要做 15 秒精准收尾、要按总谱施工——这类需求它满足不了,硬用只会浪费时间。这类人应该去网页端工具,或者干脆用传统制作流程。
第二类是不能读英文、也不打算折腾的人。界面没有中文这件事,会在每一个环节上增加摩擦,从第一次启动到写描述到看条款。如果英文阅读是障碍,那么它的核心交互(用一段话描述你想要的歌)就没法发挥,用起来会很憋屈。这类用户等中文版,或者选有中文界面的产品,是更理性的选择。
十二、结论:一个合格的口袋草稿机,还不是工作室
它做到了什么,没做到什么
把四个官方能力逐条对照下来,我的判断是:即时成歌做到了,路径清晰、门槛低、三层输入的设计比纯文本框聪明;曲风混合做到了表面,粗粒度标签能覆盖主流需求,但细分风格和段落配比还得靠描述去猜;真实感人声在英文流行这一档够用,中文咬字和乐器独奏是明显短板;灵感引擎确实存在,但它的价值取决于你愿不愿意把产出当素材而不是当成品。
它没做到的,是「工作室」这个词暗示的那部分:没有时间轴、没有参数化的编曲控制、没有像样的混音工具、没有中文。这些不是 bug,是产品定位的取舍——它要的是「一分钟出歌」,而不是「一小时做歌」。用工作室的标准要求它,本身就是错配。
所以我给它的定位是「口袋草稿机」:在想法的第一公里最快,在成品的最后一公里最弱。它适合把脑子里的东西快速变成一段能听的音频,然后你带着这段音频去找更好的工具、更强的人。这个定位不丢人,反而很清晰——大部分创作工具的真正价值,都在「让你开始」这一步。
至于值不值得装:如果你能读英文、有一台存储还行的 iPhone、并且能接受「AI 生成内容在版权上处于灰色地带」这个前提,它值得放进手机里当一个随手可用的草稿工具。如果你的需求是商交付、是精确控制、是中文表达,那它现在还不是答案,可以再等等。
最后补一句关于商店链接的说明:本文给出的 Google Play 链接是商店搜索页(关键词 Donna),搜索结果不保证命中同一应用,Android 用户点进去后需要自行核对开发者署名与应用名是否为 MOBIVERSITE 与 Donna AI Song & Music Maker。iOS 用户则可以直接用下方表格里的 App Store 链接,那个是确定的应用详情页。
Donna AI Song & Music Maker 最新版下载地址:
相关软件
全面、高效的AI工具产品情报,发现和使用最酷的AI工具!
Ctrl + D 或 ⌘ + D 收藏本站到浏览器书签栏。