

Hugging Face NLP 课程
Hugging Face 官方免费 NLP 系统课,覆盖 Transformers、微调与 RLHF
标签:AI学习网站AI学习网站 Hugging Face NLP RLHF Transformers 免费课程 模型微调大模型API全网最稳定的官方企业级渠道
Hugging Face NLP 课程官网
Hugging Face NLP 课程是 Hugging Face 官方出品的免费自然语言处理系统课程,托管在 huggingface.co/learn 学习专区。课程从 Transformer 架构原理讲起,依次覆盖 Tokenizers 分词器、Datasets 数据集处理、模型微调、共享与部署,并延伸到大语言模型的对齐与 RLHF 训练。所有章节都配有可在 Colab 中一键运行的代码,学完即可具备用开源模型解决真实 NLP 任务的能力。
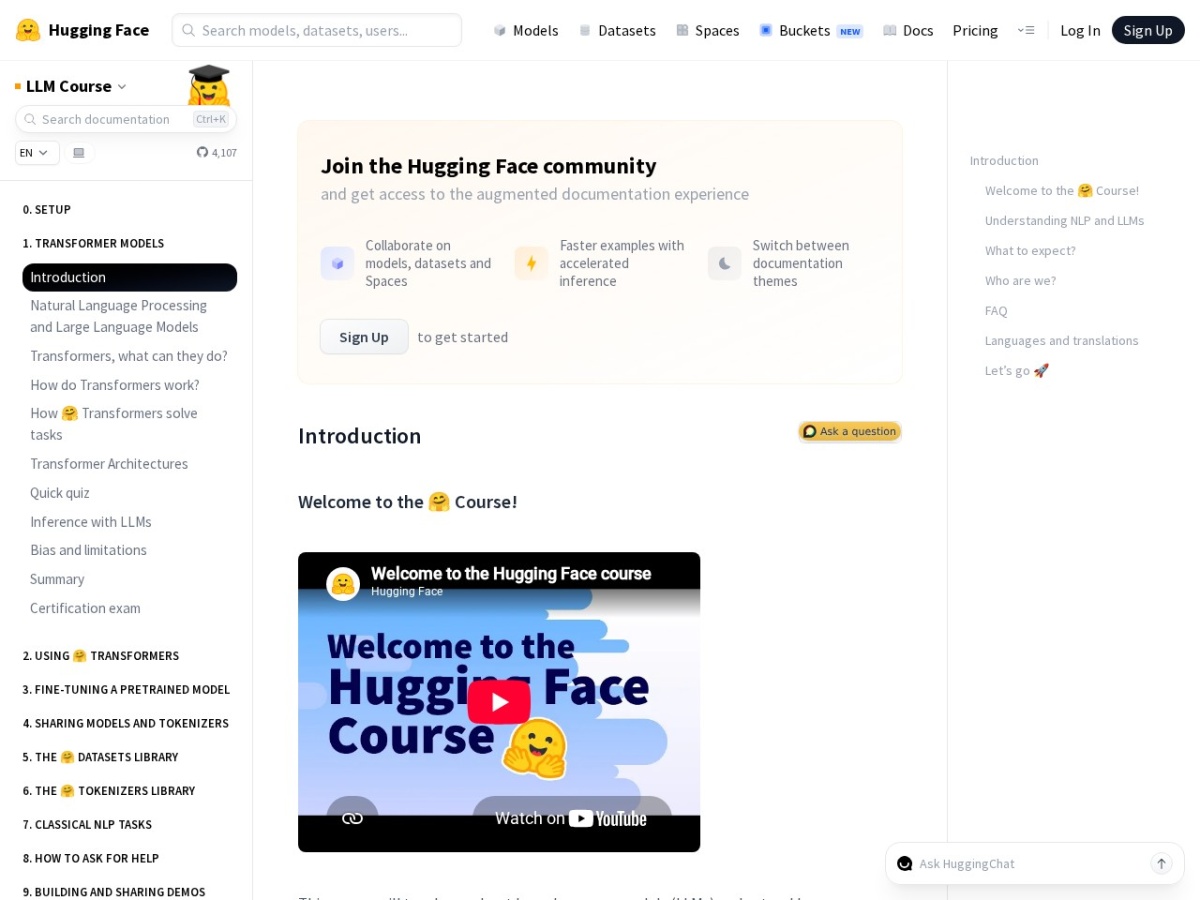 Hugging Face NLP 课程官方学习页面
Hugging Face NLP 课程的主要功能
- Transformer 原理讲解:从注意力机制讲到编码器、解码器与编码器-解码器三类架构的差异,说明为什么不同任务要选不同结构。
- Transformers 库实操:讲解 pipeline 快速推理、AutoModel 与 AutoTokenizer 的加载方式,几行代码就能跑通分类、问答、摘要等任务。
- Tokenizers 深入剖析:讲解 BPE、WordPiece、Unigram 等分词算法的差异,以及词表大小、特殊 token 对模型效果的实际影响。
- Datasets 数据处理:讲解如何加载、切分、映射与流式处理大规模数据集,避免内存爆掉这类新手常见问题。
- 模型微调全流程:使用 Trainer API 与原生 PyTorch 两种方式完成微调,并讲解学习率、批大小与评估指标的设置。
- 模型分享与部署:讲解如何把训练好的模型推送到 Hugging Face Hub,并用 Spaces 快速搭建可交互的演示页面。
- LLM 与 RLHF 章节:延伸讲解大语言模型的指令微调、偏好对齐与人类反馈强化学习的基本流程。
- 多语言支持与持续更新:课程由社区协作翻译成包括中文在内的多种语言,内容随生态演进持续修订。
如何使用Hugging Face NLP 课程
推荐学习流程:
- 访问 huggingface.co/learn/nlp-course,在页面右上角切换到中文版本(如已有社区翻译);
- 注册 Hugging Face 账号,后续推送模型、使用 Hub 与 Spaces 都需要;
- 第一章只读理论、不写代码,先把 Transformer 三类架构的适用场景弄明白;
- 从第二章开始务必动手,点击章节内的 Colab 链接直接在云端运行,无需配置本地 GPU 环境;
- 学到微调章节时,换一个自己感兴趣的数据集重跑一遍,效果远好于照抄示例;
- 完成后把模型推送到 Hub 并用 Spaces 做一个演示页,这一步能大幅加深对整个工作流的理解;
- 有余力可继续学习学习专区里的 Deep RL、Audio、Diffusion 等姊妹课程。
Hugging Face NLP 课程的使用场景
- NLP 系统入门:只会调用大模型 API,想真正搞清楚模型内部在做什么的开发者;
- 开源模型落地:企业出于成本或数据合规考虑要自建模型服务,需要掌握加载、微调与部署全链路;
- 领域微调需求:通用模型在垂直领域效果不佳,需要用自有语料做微调;
- 算法岗求职准备:面试常问分词器、注意力机制、微调策略等,课程内容与考点高度重合;
- 研究生入门科研:研究方向涉及 NLP,需要快速上手主流工具链再读论文复现;
- 高校教学素材:课程免费开源且配套 Colab,非常适合作为实验课材料。
Hugging Face NLP 课程的价格与版本
课程内容完全免费开放,无需订阅或付费即可阅读全部章节与运行示例代码。配套的 Google Colab 免费额度足以完成大多数章节的实验,只有涉及较大模型的微调才可能需要更强算力,此时可选择 Colab 付费方案或本地 GPU。Hugging Face Hub 的模型托管与 Spaces 演示空间提供免费额度,超出部分或需要私有仓库、专属推理端点时按官方定价另行计费,具体以官网价格页公示为准。
Hugging Face NLP 课程的常见问题解答
- 学这门课需要什么基础?没有深度学习背景行吗?
- 课程要求具备 Python 编程能力,并对 PyTorch 或 TensorFlow 有基本了解。不要求精通深度学习理论,但如果完全没接触过神经网络、梯度下降这些概念,前两章会读得比较吃力。建议先花几天补一门深度学习入门课,再回来学习,体验会顺畅很多。
- 在大模型时代,还有必要学 Transformers 微调吗?
- 非常有必要。API 调用解决的是通用能力问题,但涉及数据不能出内网、推理成本要压到极低、或者任务高度垂直(如特定行业的实体抽取)时,开源小模型调往往是更优解。理解分词器与模型结构,也能让你在使用大模型 API 时对上下文长度、token 计费有更准确的判断。
- 没有 GPU 可以完成课程吗?
- 可以。课程所有章节都提供 Google Colab 链接,免费版分配的 GPU 足够跑通绝大部分示例,包括小规模模型的微调。只有当你想微调较大的模型或处理超大数据集时才需要额外算力。另外,推理类的章节在 CPU 上也能运行,只是速度较慢。
Hugging Face NLP 课程官网网址
Hugging Face NLP 课程官方网址:https://huggingface.co/learn/nlp-course
相关资源:Hugging Face 学习专区 https://huggingface.co/learn。
零基础可先看站内 CS50 打底;模型 API 方向可参考 OpenAI Platform 与 DeepSeek 开放平台;实战代码可参考 OpenAI Cookbook;向量检索实现推荐 pgvector 向量搜索引擎实战。
OpenI AI时代点评
大模型 API 让很多人跳过了「理解模型」这一步,直接进入「使用模型」。短期看效率很高,长期看则会遇到天花板——当输出不稳定、成本压不下来、数据不能外发时,你需要知道模型内部到底发生了什么。Hugging Face 这门课的价值正在于此:它不教你怎么写提示词,而是把分词、注意力、微调、对齐这些底层机制讲透,让你具备在 API 之外自己动手的能力。课程另一个被低估的优点是工具链的完整性,从加载数据到推送模型再到一键部署演示,全程都在同一套生态里完成,学完的不只是知识,还有一条可以立刻用于生产的工作流。唯一要提醒的是:不要只读不做,Colab 就在旁边,每章都跑一遍才对得起这门课的质量。想继续补齐工程侧能力,可以看看 OpenAI Cookbook 里的实战示例。
数据评估
本站OpenI提供的Hugging Face NLP 课程都来源于网络,不保证外部链接的准确性和完整性,同时,对于该外部链接的指向,不由OpenI实际控制,在2026年 5月 29日 下午9:12收录时,该网页上的内容,都属于合规合法,后期网页的内容如出现违规,可以直接联系网站管理员进行删除,OpenI不承担任何责任。
相关导航


全面、高效的AI工具产品情报,发现和使用最酷的AI工具!
Ctrl + D 或 ⌘ + D 收藏本站到浏览器书签栏。