GLM-5.3-Flash 是什么
GLM-5.3-Flash 是智谱推出的开源大模型,也是 GLM-5 系列中首个原生多模态模型。它采用总参数 320 亿、运行时激活参数仅 18 亿的稀疏激活设计,在权威评测中拿下 57 分的综合智能指数,与 Claude Opus 4.8 持平,而使用成本仅约为其 1/40。通俗地讲,它把以往只有旗舰级闭源模型才具备的智能水准,以开源权重加超低门槛价格的方式交到了开发者与普通用户手中,主打”前沿智能的普惠化”。
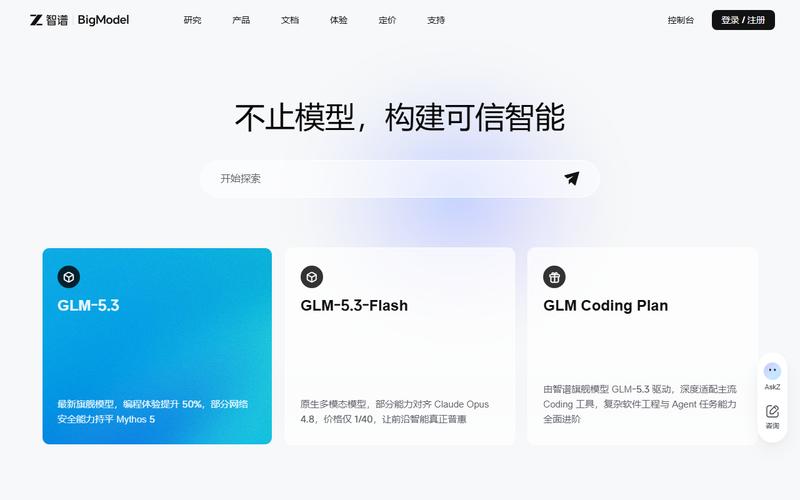 智谱 BigModel 开放平台首页已上线 GLM-5.3-Flash
与许多”参数堆出来”的大模型不同,GLM-5.3-Flash 的思路是让 320 亿总参数中的大部分处于”待命”状态,每次推理只唤醒 18 亿参数参与计算,因此它可以在保持高智能水平的同时,把推理开销压到极低的水平。加上原生多模态带来的图像理解能力,它既能读懂文字,也能”看懂”界面与画面,这为后面要讲的视觉驱动编程、办公自动化等能力打下了基础。
GLM-5.3-Flash 的主要功能
- 视觉驱动编程:模型能自主判断何时需要调用视觉反馈,在前端开发、3D 仿真与游戏构建中,根据界面渲染效果实时审视并优化代码逻辑,形成”写代码—看效果—再改进”的闭环。
- Office 文档专项优化:针对 PPTX、PDF、DOCX、XLSX 等常见办公格式做了专门调优,不仅能完成常规文档处理,还具备一定的审美判断力,可自动进行排版与美化。
- 跨平台智能体协同:通过集成 Browser Use Agent 与 Computer Use Agent,模型可以跨越浏览器、代码编辑器和图形界面,自动化协同完成复杂任务。
- 专业领域支持:在金融研报分析、法律合同审查、文书起草等高门槛场景中提供精准、可追溯的专业辅助。
- 百万级长上下文:支持百万级 token 的超长文本处理,适合整本书、大型代码库或超长报告的通读与分析。
GLM-5.3-Flash 的技术架构解析
GLM-5.3-Flash 之所以能在性能与效率之间取得平衡,核心在于对底层架构的深度重构:
- 混合架构优化:整合线性注意力与稀疏注意力机制,并借助 IndexPool 技术把缓存向量压缩,大幅削减计算负担与 KV 缓存需求,在保证长文本处理精度的同时显著降低资源开销。
- 流形约束超连接(mHC):通过对模型层数与激活参数的精细调优,在不改变参数量的前提下提升了 Scaling 扩展能力,以更轻量的资源投入实现超越 GLM-5.2 的性能表现。
- 国产算力生态适配:针对国产芯片集群的内存带宽特点,团队定制了 EPD 分离式推理引擎,并通过张量并行、W8A8 量化等手段打破算力瓶颈,使端到端推理效率提升 3 倍,达到与英伟达 GPU 阵列同台竞技的水平。
这套技术组合也让 GLM-5.3-Flash 成为国产算力大规模商业化落地的代表性案例之一:它不依赖特定海外芯片生态,在国产集群上同样能跑出高吞吐的推理表现。
如何使用 GLM-5.3-Flash
- API 接入:开发者可在智谱 BigModel 开放平台(bigmodel.cn)或 Z.ai API 官网获取密钥,直接调用 glm-5.3-flash 接口,把多模态能力嵌入自己的应用。
- 在线体验:普通用户打开 Z.ai 网页版或智谱清言 App 即可直接对话,无需任何配置。
- 工具深度使用:借助 ZCode、AutoClaw 等官方工具,可以深度体验代码协同与文档自动化功能。
- 本地化部署:有自主可控需求的机构,可从 HuggingFace 下载开源权重,在自有服务器上完成私有化部署。
- 开发者扶持:智谱推出了 GLM Coding Plan,为开发者提供限量体验资格,降低试用门槛。
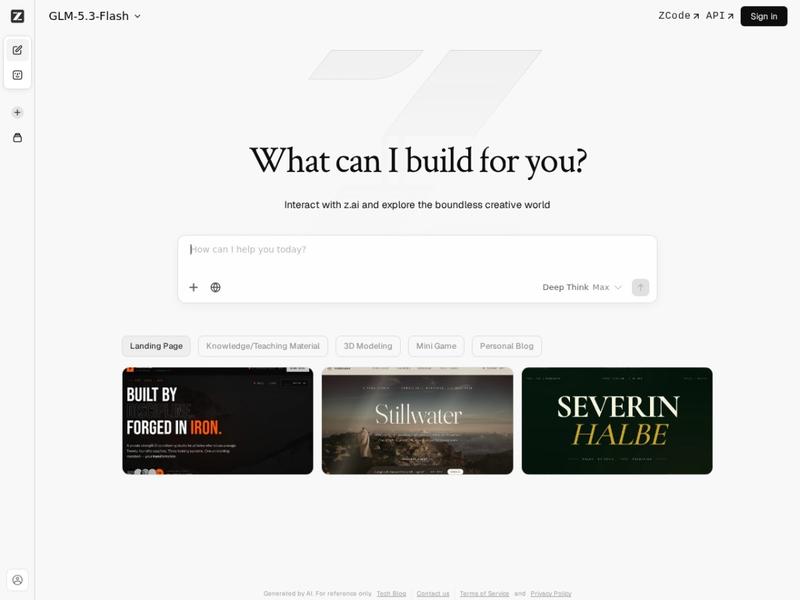 Z.ai 平台已默认提供 GLM-5.3-Flash 模型
GLM-5.3-Flash 的使用场景
- 前端与互动开发:利用视觉驱动编程能力,边渲染边优化,适合落地页、3D 场景和小型游戏的快速迭代。
- 办公自动化:批量生成与美化 PPT、整理 Excel 表格、起草与排版 Word 文档,把重复性文书工作交给模型。
- 金融与法律专业辅助:研报要点提炼、合同条款审查、标准文书起草,输出可追溯、便于人工复核。
- 智能体自动化:结合 Browser Use Agent 与 Computer Use Agent,让模型代替人工在浏览器和桌面软件中执行多步骤流程。
- 超长文档研究:依托百万级长上下文,通读长篇资料并做摘要、比对与问答。
GLM-5.3-Flash 与 Claude Opus 4.8 对比
从定位上看,两者代表了两种路线:Claude Opus 4.8 是闭源的旗舰模型,智能水平处于第一梯队,但调用价格高昂;GLM-5.3-Flash 则在综合智能指数上与其打平(57 分),却把成本压到了约 1/40,并且开放了模型权重,允许企业私有化部署。对于预算敏感、又有数据自主诉求的团队来说,GLM-5.3-Flash 提供了一条”不牺牲智能水平”的替代路径。
如果我们在国产开源模型这个更大范围内做横向比较,还可以关注同站收录的 Qwen 3.8-Max、Qwen2.5-Max 等阿里旗舰模型,以及在体验端整合了多款通义能力的 Qwen Chat;偏研究向的用户也可以对比 书生通用大模型(Intern-AI) 与 百灵大模型,各家的技术路线与 GLM-5.3-Flash 的稀疏激活方案形成了有趣的互补。
GLM-5.3-Flash 的常见问题解答
- GLM-5.3-Flash 免费吗?
- 模型权重以开源方式发布,可从 HuggingFace 免费下载并在自有环境部署;通过 BigModel 开放平台或 Z.ai API 调用则按平台规则计费,官方口径是综合成本约为 Claude Opus 4.8 的 1/40,具体价格以平台公示为准。
- GLM-5.3-Flash 支持哪些接入方式?
- 主要有四类:BigModel 开放平台 / Z.ai API 的接口调用,智谱清言 App 与 Z.ai 网页端的直接对话,ZCode、AutoClaw 等工具的深度使用,以及基于 HuggingFace 权重的私有化部署。
- GLM-5.3-Flash 比上一代强在哪里?
- 它是 GLM-5 系列首个原生多模态模型,并通过流形约束超连接(mHC)技术在参数量不变的情况下提升了 Scaling 能力,综合性能超越 GLM-5.2;配合国产算力适配,端到端推理效率提升 3 倍。
GLM-5.3-Flash 官网网址
智谱 BigModel 开放平台官网:https://bigmodel.cn/ ,可在此获取 API 密钥与模型文档;Z.ai 官网:https://z.ai/ ,网页端可直接体验 GLM-5.3-Flash;开源权重可在 https://huggingface.co/ 搜索下载,用于本地私有化部署。
OpenI AI时代点评
GLM-5.3-Flash 最有价值的点不在于某单项跑分,而在于它把”旗舰智能、开源权重、国产算力、超低价格”这几个通常互相矛盾的条件凑齐了:320 亿总参数、18 亿激活参数的设计压低了推理成本,57 分的综合智能指数证明效率没有以牺牲能力为代价,而对视觉驱动编程和 Office 文档的专项优化又让它具备了清晰的应用落点。对于想在自有环境部署多模态能力、又控制不住海外模型账单的团队,建议先到智谱 BigModel 开放平台(https://bigmodel.cn/)或 Z.ai 实测一下再决定;如果还想货比三家,不妨顺带看看 Qwen 3.8-Max 等同代旗舰模型的表现。
相关文章

全面、高效的AI工具产品情报,发现和使用最酷的AI工具!
Ctrl + D 或 ⌘ + D 收藏本站到浏览器书签栏。