Kev是什么
Kev 是一个开源的 Jev 风格决策模型家族,主打可自训练、自部署。在当今大语言模型普遍追求“能写会道”的潮流中,Kev 反其道而行之——它不仅不写任何废话,反而专注于帮人类或 AI 系统做快准狠的“判断题”。它可以无缝嵌入到需要对成百上千条分支进行自动化判断的系统里,充当一层廉价且可控的决策中枢。
Kev 源自 Cognition 工程副总裁 Jared Palmer 的开源项目。它以 Qwen3.5 和 Qwen3.8 作为强力基座,构建了一个涵盖 0.8B 到 27B 等多个尺寸的开源决策模型家族。与传统的吃苦耐劳式生成不同,Kev 的定位非常明确:把“生成”这件昂贵的事,变成一次可以批量并行、可以直接读出概率的“选择”。
 Kev 以单次前向传播输出校准概率的决策流程示意
Kev的主要功能
从使用者的角度看,Kev 并不是一个“对象”,而更像一个可编程的判断引擎。它的能力可以归纳为以下几个方面。
- 多维度结构化决策:原生支持 noul、choice 以及 score 三大核心决策原语,覆盖“是 / 否”判断、多选项选择与等级打分三类最常见的决策形态,并且拒绝输出任何冗余的解释性文字。
- 单次前向即出概率:接收状态文本和结构化问题之后,通过单次前向传播就能直接给出精准的校准概率,而不是像传统大模型那样逐 Token 生成文本。这既省掉了等待时间,也让结果天然可被程序消费。
- 极速本地部署:借助内置的 kev.serve 命令,用户可以一键拉起符合标准的高性能服务,并完美兼容 CUDA、ROCm 以及苹果自研的 Apple Silicon 芯片,显卡生态覆盖面相当友好。
- 低门槛定制化微调:不仅支持使用私有数据集对官方权重进行二次训练,更配套了强大的 kev-finetune skill,能够让 Coding Agent 自动包办数据整理、训练、评估到部署的完整工作流,把微调这件事从“专家活”降级为“流水线活”。
- 严谨的质量评估体系:内置多项冻结评测集,可实时输出准确率、Brier 分数以及校准误差等关键指标,让概率不只是“看起来像那么回事”,而是有量化依据可以参考。
- 兼容既有生态:全面兼容 TypeSafe System One 的 API 规范,意味着已经接过这套协议的系统在迁移时的摩擦成本更低。
Kev的技术架构
Kev 之所以能做到又快又准,关键在于它并没有沿用“继续做生成”的老路,而是从输出机制到注意力布局都做了针对性的重构。
指针头重构输出机制。Kev 巧妙地将 Qwen 基座的核心权重彻底冻结,仅外挂一个 rank-16 的 LoRA 适配器与轻量指针头。系统会将每个候选选项的隐藏状态与问题的决策点进行匹配打分,经 softmax 运算后直接输出概率。这就好比把原本复杂的“主观写作题”降维成了高效的“客观选择题”,彻底省去了繁琐的文本生成过程。
块因果注意力实现高效隔离。为了解决一次性处理多个问题时的信息干扰,Kev 创新性地采用了块因果注意力机制。输入序列被拆解为“公共状态 + 多个问题块”,通过精心设计的掩码,让每个 Token 只能读取到对应的状态和本问题内容。这样一来,单次前向传递就能同时并行处理海量互不相关的问题,既共享了计算资源,又保证了零污染。
精准的温度校准。在训练阶段,模型仅通过交叉熵优化适配器与指针头。而在推理前,每个 Checkpoint 都会在专属留出集上拟合一个温度参数。这一设计确保了输出的概率值具备极高的置信度参考价值——对自动化管线而言,一个“可以被信任的 0.8”远比一段含糊的解释更有意义。
如何使用Kev
Kev 的使用路径分为“直接跑起来”和“训练成自己的”两条,前者几分钟就能完成,后者则可以交给 Coding Agent 托管。
- 准备 Python 环境:在本机或服务器上准备好 Python 运行环境,建议使用虚拟环境隔离依赖,并确认显卡驱动与对应的加速库(CUDA / ROCm)已正确安装。
- 安装项目依赖:通过项目推荐的相关包管理器安装依赖。若使用 uv,可在安装时带上 serve 相关的 extra,以便一并拉起服务端所需的组件。
- 一键启动服务:在项目根目录运行类似 KEV_DTYPE=bf16 uv run –extra serve python -m kev.serve 的指令,即可启动本地服务;通过 KEV_DTYPE 可以指定 bf16 等推理精度。
- 调用三大决策原语:服务起来后,按照 noul(是 / 否)、choice(多选一)、score(等级打分)三种形态构造结构化问题,连同公共状态文本一起提交,即可批量取回校准后的概率。
- 云端弹性部署(可选):如果本地没有合适的显卡,项目还支持通过 Modal 等云端工具进行一键弹性部署,用多少算力付多少费用。
- 用 kev-finetune 做定制:当有私有业务数据时,可通过配套的 kev-finetune skill,让 Coding Agent 自动完成从数据整理、模型训练、效果评估到最终部署的完整流程。
- 读取评估指标:通过内置的冻结评测集查看准确率、Brier 分数与校准误差,判断当前 Checkpoint 是否已经具备上线条件。
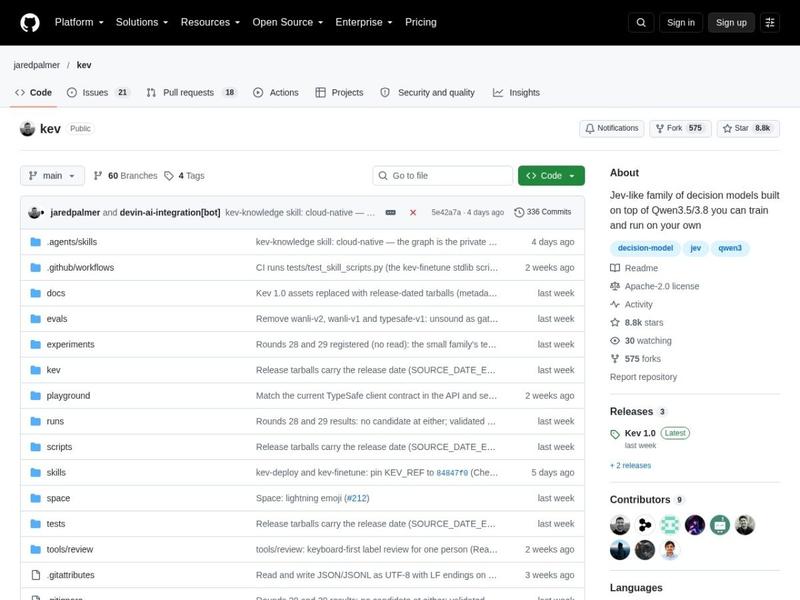 使用 kev.serve 在本地启动 Kev 决策服务
Kev的使用场景
凡是“需要大量重复判断、且判断结果必须可被程序消费”的业务,都是 Kev 的主战场。以下是几个典型的落地形态。
- 智能客服工单路由:一次性完成部门分流、人工升级判定及客户情绪等级评估。高置信度的请求可以直接走自动化处理,低置信度的再转人工,既省人力又保证兜底。
- 内容安全与合规审核:对海量 UGC 文本并行执行违规检测、类型归纳与严重程度打分。得益于块因果注意力,一大批互不相关的文本可以在一次前向里批量判完,吞吐非常可观。
- 金融信贷与风控初审:快速对各类风险等级和合规需求进行概率量化,把原本需要人工逐条过目的材料先做一轮机器预筛,显著提升人工复核的效率。
- 电商意图识别:精准捕捉用户的多标签搜索诉求,将流量完美分发至最合适的下游系统,让推荐、搜索与客服三条链路各司其职。
- Agent 流程中的分支裁决:在自动化编排里充当轻量裁判,用毫秒级的延迟决定下一步走哪条分支,相比再调一次通用大模型,成本与延迟都低得多。这类用法也常见于 天工超级智能体 一类的编排体系中。
Kev与同类工具对比
在开源版本与传统商业闭源方案的较量中,Kev 展现出了极强的竞争力。Jev 作为单一托管的商业 API,虽然在某些特定开发集上的准确率略高,但 Kev 提供了从 0.8B 到 27B 的丰富档位选择,在模型尺寸上更具灵活性。同时,Kev 的置信错误率低至 4.0%,配合完全免费的开源权重、本地化私有部署以及零调用费用的优势,使其综合性价比和数据隐私安全性远超同类闭源竞品。
| 对比维度 | Kev | Jev |
|---|---|---|
| 产品形态 | 开源决策模型家族,权重公开,可自训练、自部署 | 单一托管的商业 API |
| 尺寸档位 | 0.8B 到 27B 多个尺寸可选 | 单一托管形态,不提供尺寸选择 |
| 开发集准确率 | 在部分特定开发集上略低于 Jev | 在部分特定开发集上准确率略高 |
| 置信错误率 | 低至 4.0% | 文中未提供同类公开数据 |
| 费用模式 | 开源权重免费,本地推理零调用费用 | 按商业托管计费 |
| 数据与隐私 | 本地化私有部署,确保数据不出境 | 请求需发往服务商托管环境 |
综合来看,这是一次典型的“通用能力与极致性价比”的取舍:如果你追求的是某一个公开开发集上的极限分数,闭源方案仍有优势;但如果你要在生产环境里每天跑几十万次判断、且对延迟、成本与数据合规都很敏感,那么开源自部署路线的吸引力会被迅速放大。
Kev的常见问题解答
- Kev 是完全免费的吗?
- Kev 基于 Apache-2.0 协议发布,开源权重完全免费,本地私有部署下也没有 API 调用费用。官方公布的完整训练开销不到百元美金,基于私有数据做一次微调的单次成本更是低至 1 美元左右。真正的成本来自你运行推理所用的硬件或云端算力。
- Kev 与传统生成式大模型有什么本质区别?
- 传统大模型依靠逐个 Token 生成文本,输出的是自然语言;Kev 接收状态文本和结构化问题后,通过单次前向传播直接输出校准概率,并且不会产出冗余解释。它通过冻结 Qwen 基座权重、外挂 rank-16 的 LoRA 适配器与轻量指针头,把“主观写作题”降维成“客观选择题”,因此在批量判断任务上的吞吐与延迟优势非常明显。
- Kev 支持在哪些硬件上部署?
- 通过内置的 kev.serve 命令可以一键启动符合标准的高性能服务,官方说明其完美兼容 NVIDIA CUDA、AMD ROCm 以及苹果自研的 Apple Silicon 芯片。此外,也可以使用 Modal 等云端工具进行一键弹性部署。训练成本方面,官方给出的完整训练开销不到百元美金。
Kev官网网址
Kev 是开源项目,官方代码仓库托管在 GitHub,包含模型权重、服务启动命令与微调工具链。
官网:https://github.com/jaredpalmer/kev
OpenI AI时代点评
Kev 让人眼前一亮的地方,在于它诚实地回答了一个被很多人忽略的问题:我们真的每一次都需要模型“说话”吗?在现实的业务系统里,大量的中间环节其实只需要一个可解释、可阈值化的判断结果。把这部分需求从昂贵的生成式推理里剥离出来,用一层轻量的决策模型兜住,既省下了真金白银,也让系统整体的延迟曲线好看了很多。
更值得一提的是它的成本结构。完整一次训练不到百元美金、单次私有微调约 1 美元、权重 Apache-2.0 且本地部署零调用费——这组数字基本把“自建决策层”这道门槛踏平了。对于数据合规要求严格的金融、内容审核与企业内部系统来说,数据在境内、在自己机房,本身就是最强的说服力。
当然,它也不是:Kev 专注的是结构化判断,不适合做开放式创作,也不该被拿来替代通用对话模型。合理的搭配方式是让通用模型负责理解与生成,让 Kev 这类轻量模型负责高频裁决。如果你正在搭类似的架构,不妨把 Laya决策模型、AI大模型聚合平台 放进选型清单做横向比较;动手环节则可以结合 免费AI编程工具、Code0 这类工具来加速 kev-finetune 的落地。完整源码与说明请见 Kev 的 GitHub 仓库。
相关文章

全面、高效的AI工具产品情报,发现和使用最酷的AI工具!
Ctrl + D 或 ⌘ + D 收藏本站到浏览器书签栏。