Open-RAIL 是什么
Open-RAIL 是中国移动具身智能产业创新中心于 2026 年 9 月 16 日向全球开源的具身智能推理执行通用底座。按官方定义,它是行业内首个连接 VLA / WAM 模型与机器人本体之间的通用工程底座,既不锁定具体的机器人型号,也不绑定特定的模型,目标是把”模型能想明白”和”机器人能做得稳”这两件事之间的工程鸿沟一次性填平。
要理解它解决的是什么问题,需要先看清当前具身智能落地的尴尬现状:一边是 VLA、WAM 这类大模型在论文和演示里表现惊艳,但推理频率通常只有 5–10Hz,也就是每秒最多给出几条”下一步该怎么做”的决策;另一边是真实的机器人本体,关节控制频率普遍在 200–500Hz,中间存在 30 到 50 倍的速率差距。更麻烦的是,不同厂商的机器人通信协议、关节定义、状态接口各不相同,每换一台机器、每换一个模型,工程团队都要重做一遍适配。结果是算法迭代很快,真正跑到实体上的却很少。
第三重困难则来自数据侧:具身智能模型的迭代高度依赖真实交互数据,但一次运行产生的多视角图像、关节状态、模型输出、实际控制指令往往散落在不同模块里,格式各异、时间戳对不齐,需要额外投入大量人力做清洗才能用于训练。结果是”跑得越多、浪费得越多”。
Open-RAIL 的定位正是补齐这层”缺失的中间层”:它不训练模型,也不生产机器人,而是负责把两者可靠、低延迟、标准化地连起来,并且顺手把运行过程中产生的数据自动归档,反哺下一轮模型迭代。对于正在跟进这一方向的团队,openloong开源社区 与 AI开源方案库 中收录的相关项目可以作为横向参照。
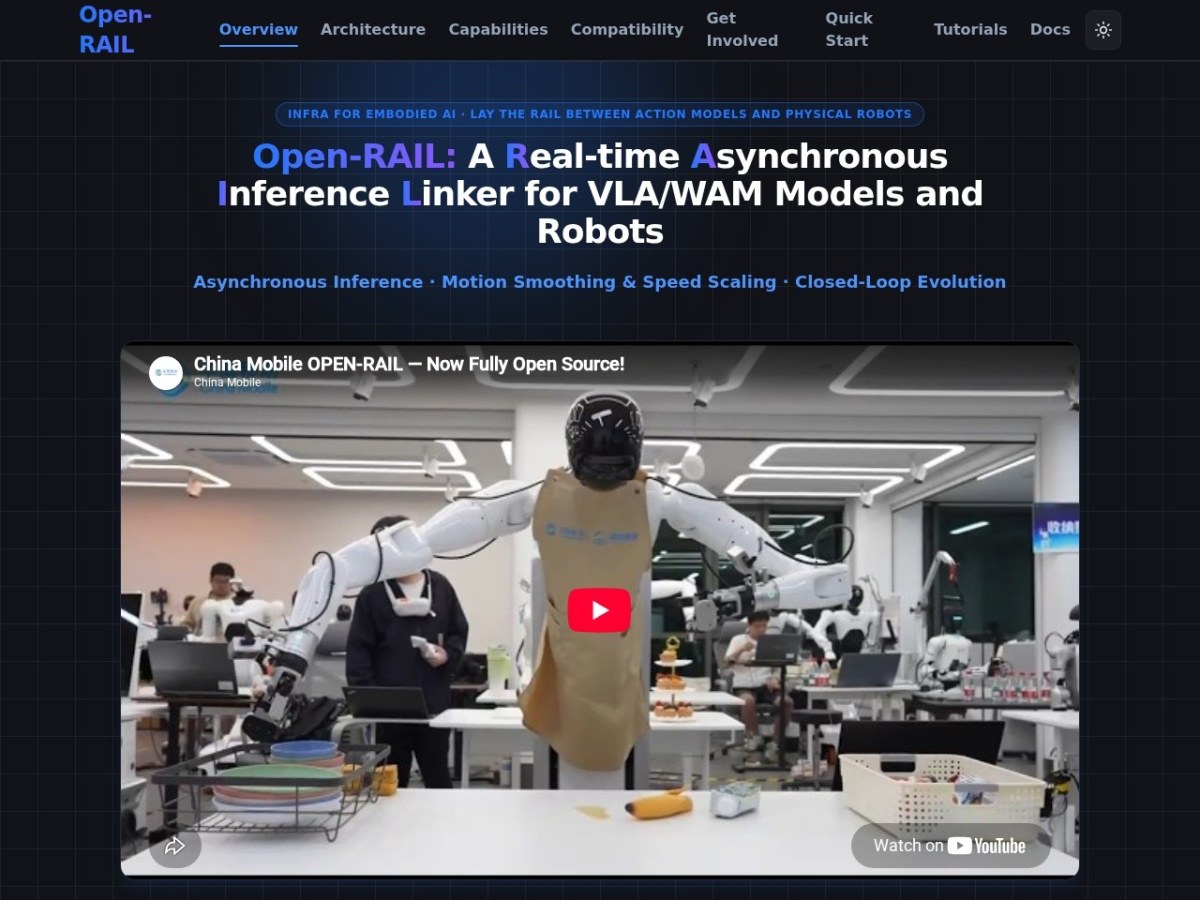 Open-RAIL 项目官方主页
从官网的介绍可以看出,Open-RAIL 对自己的定义是”A Real-time Asynchronous Inference Linker for VLA/WAM Models and Robots”——一个面向 VLA / WAM 模型与机器人的实时异步推理连接器。关键词是”实时”与”异步”:实时,是因为它要扛住机器人本体 200–500Hz 的控制节奏;异步,是因为它不要求模型推理与之同步,而是用工程手段让两种节奏各跑各的、互不拖累。围绕这两个关键词,它的能力可以概括为四条主线。
Open-RAIL 的四大核心能力
Open-RAIL 的能力可以概括为四条主线:让异步节奏对得上、让动作输出足够平滑、让部署形态切换、让适配成本大幅下降。这四条分别对应具身智能落地时最常卡住的四个环节,彼此之间又有明确的依赖关系——先把节奏打通,才有可能谈动作质量;先把算力与控制解耦,才有可能谈部署灵活性;先把硬件差异抽象掉,才有可能谈适配效率。
- 三线程异步流水线:把观测、推理、控制拆成三条并行线程,彼此互不等待。传统的同步方案里,控制线程必须等到模型给出新推理结果才能继续,机器人会呈现”走一步、卡一下、再走一步”的顿挫感;而在异步流水线里,控制线程始终按自己的高频节奏运行,用最新的推理结果做插值与跟踪,模型慢一点也不会让本体停下来。
- 块内、块间两级在线动作平滑:这是抹平 30–50 倍频率差距的关键。所谓”块内平滑”处理单个推理块内部的轨迹连续性,”块间平滑”处理相邻两个推理块衔接处的跳变。官方给出的数据是:在不修改模型权重的前提下,关节加速度标准差从 10+ rad/s² 大幅降至 0.1 rad/s²,提升约两个数量级——这意味着机器人的肢体动作从”抽搐”变成了”流畅”。
- Server-Client 端边云解耦:推理统一放在 Server 端执行,机器人侧只负责接收指令、执行动作、上报状态。因为算力压力被集中到了服务端,嵌入式算力受限的终端设备也能驱动体量庞大的 VLA 模型。更重要的是,端、边、云三种部署形态可以做到代码零改动切换,同一套业务代码在本地工控机、边缘服务器和云端集群上都能跑。
- 轻量级硬件抽象层:通过统一的接入规范把不同机器人的差异收敛到一层薄薄的抽象里。官方数据显示,接入一款新机器人的时间从原本”以周计”压缩到”以小时计”,而对接一个全新的大模型通常只需要编写 50 到 100 行代码。目前 Open-RAIL 已适配 4 款异构机器人——宇树 G1、智元精灵 G1、浙江人形 wa1、中国移动灵犀,并支持 10 个主流 VLA / WAM 模型。
把这四条合起来看,Open-RAIL 实际上做了两件不同的事:前两条是实时性工程,解决模型输出与物理执行之间的节奏与质量问题;后两条是工程效率工程,解决跨机型、跨模型、跨部署环境的复用问题。前者决定机器人能不能”像样地动起来”,后者决定这套能力能不能规模化复制。对一个想要被产业广泛采用的通用底座来说,两者缺一不可。
官方给出的落地数据也能佐证这套设计的有效性:移动星厨机器人在杭州园区常态化运行,日均出杯咖啡超百杯,单杯拿铁全流程约 90 秒,且支持多订单并行、全程由模型自主决策。长序列、多步骤、需要动作平稳的商用服务,恰恰是对异步流水线与两级平滑策略压力最大的场景。
Open-RAIL 的「推-采-评」闭环
除了让模型跑起来,Open-RAIL 另一项容易被低估的能力是把数据采集与评估机制内嵌进每一次运行。传统做法里,数据采集往往是一次专门的”采集任务”,需要额外安排人力、脚本和存储规范;而在 Open-RAIL 中,多视角图像、关节状态、推理结果、平滑后的指令以及完整的时序信息,会在机器人正常工作的同时自动归档成开箱即用的标准格式,直接就能用于下一轮训练与评测。
这就形成了官方所说的”推-采-评”良性循环:推理产生数据,数据反哺训练,训练提升推理。对具身智能这种极度依赖真实交互数据的领域来说,把闭环自动化,价值不亚于推理本身。尤其是时序信息的全链路归档——多视角图像、关节状态、推理结果、平滑指令各自打上严格的时间戳——使得事后可以完整回放一次任务执行的决策过程,无论排查问题还是分析失败案例,都有了可靠的依据。
这也就解释了为什么官方强调归档结果是”开箱即用的标准格式”:如果数据只是被存下来、还需要人工整理才能喂给训练框架,那闭环就不算真正闭合。把格式标准化这一步做在采集侧,下游团队拿到的就是可以直接使用的样本,中间的转换成本被彻底省掉。
此外,Open-RAIL 支持人机混合遥操纠偏:当模型出现偏差时,人类操作员可以随时介入接管并实时纠正,系统生成的纠偏轨迹会与原始轨迹按时间戳严格对齐并行保存。这一点看似细节,实则是数据能否直接用于训练的分水岭——如果纠偏段与原始段的时间对不上,这批数据就只能丢弃。
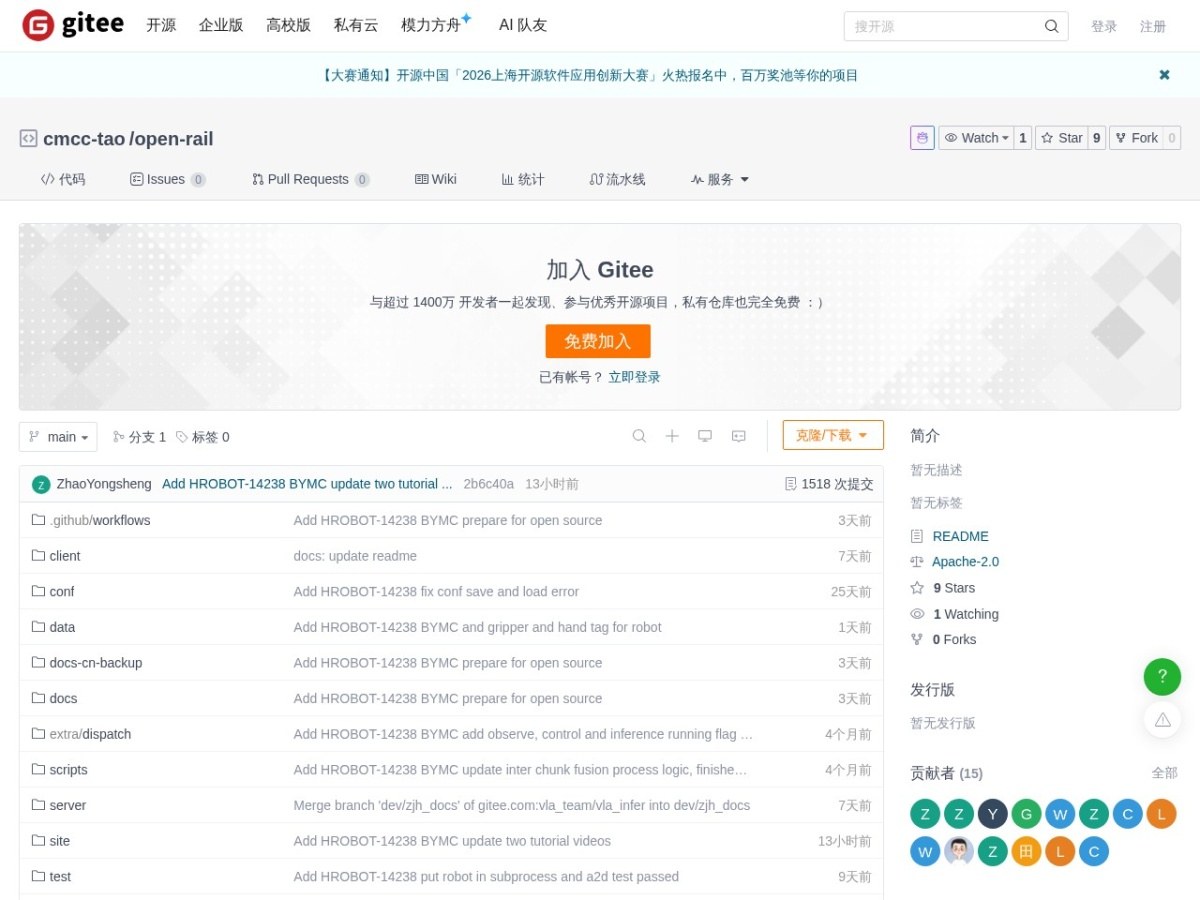 Open-RAIL 在 Gitee 上的开源仓库
如何使用 Open-RAIL
Open-RAIL 面向的是机器人工程团队与算法研究人员,使用路径可以分成”跑通示例”和”接入自己的本体 / 模型”两个阶段。
- 获取源码:前往官方主页 https://cmcc-tao.github.io/open-rail/ 或 Gitee 仓库 https://gitee.com/cmcc-tao/open-RAIL 克隆代码,按仓库文档准备运行环境与依赖。
- 选择部署形态:根据算力条件决定推理 Server 部署在端侧工控机、边缘服务器还是云端集群。由于采用 Server-Client 解耦架构,这一选择不影响业务代码,后续也可以平滑迁移。
- 跑通已有组合:先从已适配的 4 款机器人(宇树 G1、智元精灵 G1、浙江人形 wa1、中国移动灵犀)与 10 个主流 VLA / WAM 模型中选择一个组合,直接运行官方示例,观察异步流水线与动作平滑的实际效果。
- 接入新机器人:实现轻量级硬件抽象层约定的接口,把本体的状态上报与指令执行对接进去。按官方口径,这一步通常以小时计而非以周计。
- 接入新模型:按统一规范编写适配代码,通常 50 到 100 行即可完成一个 VLA / WAM 模型的接入。
- 开启数据闭环:运行过程中系统会自动归档多视角图像、关节状态、推理结果、平滑指令与时序信息;如需人工纠偏,通过人机混合遥操介入,纠偏轨迹会与原始轨迹对齐保存,可直接用于训练。
在正式接入之前,建议先用官方已适配的机器人与模型组合跑通一遍完整链路,观察异步流水线与动作平滑的实际效果,并确认数据归档格式符合自己训练框架的预期。跑通之后再替换成自有本体与模型,可以把问题定位范围缩到最小——毕竟这一层涉及实时性、通信与硬件接口,变量较多,分步验证比一次性替换要稳妥得多。
需要强调的是,Open-RAIL 本身不修改模型权重,动作稳定性的提升全部来自工程侧的流水线与平滑策略。这意味着你可以把它叠加在现有的模型之上,而不必重新训练或微调——这对已经投入大量算力训练模型的团队来说,接入成本非常低。
Open-RAIL 的使用场景
由于同时解决了频率对齐、部署解耦、适配成本和数据闭环四个问题,Open-RAIL 的适用面覆盖了从科研验证到规模化商用的完整链路。
- 高校与科研机构算法验证:研究团队最痛苦的不是想出新算法,而是把算法跑到实体上验证。Open-RAIL 把机器人适配压到小时级、模型接入压到百行代码,研究者可以把精力集中在算法本身,而不是反复重写通信与同步逻辑。对于预算有限、难以自研工程中间层的实验室,这类开源底座的价值尤其直接。
- 工业场景的具身智能改造:产线上的机械臂、AGV、巡检机器人型号繁杂,协议各异。统一的硬件抽象层让同一套智能能力可以跨机型复用,端边云解耦则让算力有限的现场设备也能用上大模型。
- 商用服务机器人:这是 Open-RAIL 目前最直观的落地方向——中国移动自研的移动星厨机器人就运行在 Open-RAIL 之上,已在杭州园区常态化运行,日均出杯咖啡超百杯,单杯拿铁全流程约 90 秒,支持多订单并行,全程由模型自主决策。机器人在连续制作一杯拿铁的过程中需要完成一系列精度要求不同的动作,任何一次输出跳变都可能变成一次事故,每天上百杯的稳定复现,正是对异步流水线与两级平滑策略最直接的工程验证。
- 多本体异构集群统一管理:当一个场地里同时存在不同厂商的机器人时,Open-RAIL 可以作为统一的推理执行层,向上承接模型、向下屏蔽差异,避免为每种机型维护一套系统。
- 真实交互数据规模化采集:需要大量真实操作数据训练具身模型的团队,可以直接借助内嵌的采集与归档能力,把日常运行变成数据生产,并通过人机混合遥操纠偏持续提升数据质量。
- 具身智能教学与竞赛:统一的接入规范与开箱即用的数据格式,也适合作为教学与竞赛的统一底座,降低学生团队接触真实机器人的门槛。
- 服务与接待场景的能力升级:在已有的服务型机器人上叠加 VLA / WAM 模型,是提升交互自然度与任务泛化能力的常见思路。Open-RAIL 提供的平滑与解耦能力,可以让这类叠加不必改动原有控制栈,也不必为了算力再去更换本体硬件。相关形态可参考 酷猫云Ai智能客服机器人 这类对话服务型产品,二者代表了”云端对话智能”与”本体执行智能”两条不同路径。
可以看出,这些场景的共同诉求都是”少做重复工程、多用现成模型”。Open-RAIL 并不直接产出智能,而是让已有的智能更容易落到物理世界里去。
如果你关注机器人本体的产业进展,可以进一步参考 智元机器人 的产品与开源动态;若想了解 AI 能力在机器人上的不同落地形态,AI机器人应用、小智 AI 机器人、TCL Ai Me陪伴机器人、元萝卜AI下棋机器人 分别代表了陪伴、交互、对弈等几条差异化路线,与 Open-RAIL 所处的工程底座层形成互补。
Open-RAIL 的常见问题解答
- Open-RAIL 是一个模型,还是一个工程框架?
- 它是一个工程底座,不是模型。Open-RAIL 自身不提供 VLA / WAM 模型,也不参与模型训练,而是负责把已有的 VLA / WAM 模型与机器人本体连接起来:处理推理频率与控制频率之间的 30–50 倍差距、做两级在线动作平滑、屏蔽不同机型的硬件差异、并把运行数据自动归档。官方明确提到它在提升动作平稳性时”不修改模型权重”,这点最能说明它的定位——叠加在模型之上的工程层。换个角度看,它服务的对象不是”想训练一个更好的模型”的人,而是”已经有一个模型,想让它在本体上稳定跑起来”的人。
- 接入一款新机器人或新模型,工作量到底有多大?
- 按官方口径,借助轻量级硬件抽象层与统一接入规范,接入一款新机器人的周期从原本”以周计”压缩到”以小时计”;接入一个新的大模型通常只需编写 50 到 100 行代码。目前底座已适配宇树 G1、智元精灵 G1、浙江人形 wa1、中国移动灵犀 4 款异构机器人,并支持 10 个主流 VLA / WAM 模型,可以参考这些既有实现来估算自己项目的适配量。
- 机器人本体算力很弱,能跑得动 VLA 大模型吗?
- 可以。这也是端边云解耦设计要解决的核心问题之一。Open-RAIL 采用 Server-Client 端边云解耦设计,推理统一在 Server 端完成,机器人侧只负责执行指令与上报状态,因此嵌入式算力受限的终端也能驱动体量庞大的 VLA 模型。同时,端、边、云三种部署形态可以做到代码零改动切换,你可以先在本地工控机上验证,再按实际需要迁移到边缘服务器或云端,无需重写业务代码。
Open-RAIL 与同类工具的定位对比
具身智能领域并不缺少开源项目,但大多数项目各管一段。理解 Open-RAIL 的位置,最好的方式是看它与几类常见方案的边界:
| 项目 / 类别 | 主要定位 | 与 Open-RAIL 的关系 |
|---|---|---|
| LeRobot | 面向具身智能的训练库与数据格式标准 | 解决”怎么训、数据怎么存”,不解决”训好的模型怎么稳稳地跑到本体上”,与 Open-RAIL 是上下游衔接关系 |
| ROS | 机器人底层通信与控制的通用抽象 | 解决节点间通信与设备驱动,不处理模型推理节奏与动作平滑,属于 Open-RAIL 之下的基础设施 |
| VLA / WAM SH、RTC | 模型级的单点优化方法 | 从模型或算法侧改善特定指标,通常需要改动训练或推理流程,而 Open-RAIL 不改模型权重、面向通用工程层 |
| Open-RAIL | 连接模型与本体的通用推理执行底座 | 补的是”把它们连起来的通用层”:异步流水线、两级平滑、端边云解耦、硬件抽象、推-采-评闭环 |
这个定位背后其实是一个更本质的判断:具身智能的瓶颈正在从”模型能力”转向”工程连接”。当 VLA / WAM 模型的能力每隔几个月就上一台阶时,限制落地的往往不再是模型不够聪明,而是模型与本体之间的接口太脆弱、太定制化、太难复用。谁把这层做成了通用件,谁就掌握了产业化的关键位置。
换句话说,Open-RAIL 并不想取代任何一个已有项目,而是填上了它们之间长期空缺的那一环。对工程团队来说,这意味着可以继续使用熟悉的训练库、通信框架和模型优化方法,只在”模型到本体”这一段换成 Open-RAIL,迁移成本相对可控。
在更宽的工具链视角下,Open-RAIL 归档出的标准数据还可以与 MinerU 开源高质量数据提取工具、olmOCR 开源 PDF 文字提取 AI 工具 等文档处理组件配合完成资料侧整理;其任务编排与外部系统对接思路,也可参考 n8n 开源工作流自动化平台 的做法进行扩展。
最后值得注意的是开源策略本身。中国移动选择把这样一层底座完整开源,并同步提供 GitHub Pages 主页与 Gitee 仓库两个入口,对国内团队来说接入门槛进一步降低——Gitee 通道在网络访问上的便利性,往往决定了国内工程团队实际”用不用得起来”。对一个希望被产业广泛采用的通用底座来说,可及性本身就是竞争力的一部分。
Open-RAIL 官网网址
Open-RAIL 项目主页(GitHub Pages):https://cmcc-tao.github.io/open-rail/
Open-RAIL 开源仓库(Gitee):https://gitee.com/cmcc-tao/open-RAIL
你可以通过项目主页了解架构说明、能力介绍与最新进展,也可以直接前往 Gitee 仓库获取源码、阅读接入文档、提交 issue 或参与贡献。项目由中国移动具身智能产业创新中心于 2026 年 9 月 16 日面向全球开源,属于较新的开源项目,建议关注仓库的更新节奏与发布说明,以便及时获取新适配的机型与模型。
如果你是本体厂商或模型团队,也可以重点关注仓库中的接入规范部分——Open-RAIL 的通用性取决于抽象层约定是否被广泛接受,参与规范讨论同样是一种有价值的贡献方式。
OpenI AI时代点评
评估这类项目时,有一个简单的判断标准:看它是在替你做决定,还是在替你省事。替你做决定的产品会绑定模型、绑定硬件、绑定云服务,短期体验顺滑,长期则处处受限;替你省事的产品只把重复劳动标准化,把选择权留给你。Open-RAIL 明显属于后者——它不锁定机器人型号、不绑定特定模型、不改模型权重,只负责把连接这件事做扎实。这种克制在工程领域往往比”全家桶”更可持续。
具身智能这几年最不缺的是惊艳的演示视频,最缺的是能稳定复现、能跨机型复用、能持续积累数据的工程体系。Open-RAIL 的价值恰恰在于它不追演示效果,而是老老实实去解决那些”不上镜但致命”的问题:模型 5–10Hz、本体 200–500Hz,中间差 30–50 倍怎么办?动作抖得没法看怎么办?换一台机器人就要重写一遍怎么办?跑完一轮之后数据散落各处怎么办?
从公开信息看,几个技术判断都相当务实。三线程异步流水线解决的是”别让快的等慢的”,两级在线动作平滑解决的是”别让输出跳变”,两者叠加后把关节加速度标准差从 10+ rad/s² 压到 0.1 rad/s²——这个数字比任何形容词都更能说明动作质量的变化。而”不修改模型权重”这一条尤其聪明:它意味着团队不必为了工程稳定性去牺牲已经训练好的模型能力,接入门槛因此大幅降低。
更值得注意的是端边云解耦与硬件抽象层的组合。前者让算力弱的本体也能用上大模型,并且端 / 边 / 云切换不改代码;后者把新机型适配从”以周计”压到”以小时计”、新模型接入压到 50–100 行代码。这两件事合在一起,实际上是在降低整个行业的试错成本——当换机器、换模型都不再伤筋动骨时,算法迭代的速度才会真正兑现到实体上。
当然,作为一个刚刚开源的新项目,Open-RAIL 还有很长的路要走:已适配的 4 款机器人与 10 个模型只是起点,生态规模、社区活跃度、长期维护投入都还有待观察;”推-采-评”闭环能否真正沉淀出高质量数据集,也需要时间检验。但中国移动自研的移动星厨机器人已经在杭州园区常态化运行,日均出杯超百杯、单杯拿铁约 90 秒、支持多订单并行且全程模型自主决策——这个案例至少证明了它不是纸面方案。
对国内具身智能产业来说,由运营商背景的产业创新中心开源一个”通用中间层”,本身就是一种颇有信号意义的动作:它不押注某一家本体厂商,也不绑定某一个模型,而是把公共工程能力开放出来。若这套底座能被社区广泛采用,行业分工会变得更清晰——有人专心做模型,有人专心做本体,中间的工程层由 Open-RAIL 这类项目兜住。对正在搭建具身智能技术栈的团队来说,现在就把这一层纳入评估,成本很低,收益却可能随生态成长不断放大。感兴趣的读者可以从 Open-RAIL 项目主页 入手,也可以对照 AI开源方案库 中收录的其他具身智能相关项目一起评估。
相关文章


全面、高效的AI工具产品情报,发现和使用最酷的AI工具!
Ctrl + D 或 ⌘ + D 收藏本站到浏览器书签栏。